
沙箱只读 query 能力:业务人员如何在沙箱中安全地访问数据?
沙箱只读 query 能力:业务人员如何在沙箱中安全地访问数据?
一、让业务人员查数据,又不让他改数据
2026 年 7 月某跨境电商集团的财务经理在编写对账脚本时遇到了一个真实的尴尬:他想判断「这 1200 行账单里,跟我这 800 个供应链订单匹配上的到底有哪些」,需要把 BillRow 和 SupplyOrder 两个模型的数据在脚本里交叉比对。研发团队给的方案是「写一个内部 RPC 接口,参数是业务订单号列表,返回供应链订单明细」,接口排期两周。
两周。这是把"内部数据库 join"包装成"内部微服务调用"的典型代价——研发把 90% 的能力挡在了接口设计背后,业务人员的每一条新逻辑都要再走一遍接口评审。
但如果业务人员的脚本直接在沙箱里查数据库呢?同样让人夜不能寐:
- 沙箱里的脚本是用户写的,用户可不可以用
prisma.user.findMany()把全部用户表(含密码哈希)拉走? - 沙箱里只开放了
findMany,用户循环调用 1000 次会不会把 PG 连接池打爆? - 沙箱里的
where参数支持任意 JSON,用户能不能在原型链上挂toJSONgetter 干扰 Prisma 内部取值? - 沙箱里的脚本如果能写数据库,整套只读隔离等于白做——可脚本又必须能根据查询结果计算对账结果,怎么办?
这就是「沙箱只读 query 能力」要解决的核心问题:业务人员需要在沙箱里读数据库,但只能在严格的边界里读。边界外的危险操作(写、$queryRaw、事务、user/appKey/systemSetting 整张表)必须一刀切掉;边界内的合法操作(findMany/count + 命名助手 + 上下文绑定)要让业务人员感觉"够用且不多余"。
沙箱 query 设计的核心不是"允许什么",而是"为了安全主动放弃了什么"。
下面我们以 apps/api/src/biz_reconciliation/common/sandbox-query.ts(4 类沙箱共用的 235 行实现)为骨架,拆解这个边界是怎么划出来的。
二、查沙箱 query 在整个沙箱架构中的位置
要谈沙箱 query 的设计取舍,必须先看清它处在沙箱体系的哪一层。看下面这张架构图:

注意左下角那个不起眼的方块——query 是沙箱里唯一的受控数据出口。沙箱里禁网络(无 fetch)、禁文件系统(无 fs)、禁子进程(无 child_process),但业务脚本必须能拿到数据,否则沙箱里的脚本就是个空壳。query 就是那扇窗:能看什么、能看多少、不能看什么,全部由它决定。
把视角拉远一点,看端到端数据流:

这张图把沙箱 query 的真实定位讲清楚了:原始账单导入后,BillRow 落库;接着收入对账沙箱用 query 拿 BillRow 与 SupplyOrder 做匹配;费用分摊沙箱用 query 反查已对账的收入项;集成转换沙箱用 query 找营销对账行做差异判定;最后推送金蝶云星空。沙箱 query 在数据流的后半程几乎全程在线——它不是 nice-to-have,是必须。
三、能力边界:白名单 + denylist 的「宁缺毋滥」取舍
边界设计的关键问题是:沙箱里的 query 应该长什么样?
最朴素的设计是「开放整个 PrismaClient,让用户随便查」。这种设计在 demo 阶段没问题,在生产环境是灾难——user 表里的密码哈希、appKey 表里的 HMAC 密钥、systemSetting 里的数据库连接串,全部对用户脚本透明。
稍微严谨一点的设计是「按模型开放 findMany,其他方法禁」。这就开始接近沙箱 query 的真实形态了。但真正难的是确定哪些模型开、哪些模型关。
看代码里的核心实现:
// common/sandbox-query.ts(节选)
const GENERIC_QUERY_DENYLIST = new Set(["user", "appKey", "systemSetting"]);

export function buildGenericQuery(): Record<string, unknown> {
  const client = getSandboxPrisma() as unknown as Record<string, unknown>;
  const query: Record<string, unknown> = {};
  for (const key of Object.keys(client)) {
    // $ 前缀 = Prisma 内部方法($queryRaw / $transaction 等一律不开放)
    // _ 前缀 = 私有字段
    if (key.startsWith("$") || key.startsWith("_")) continue;
    if (GENERIC_QUERY_DENYLIST.has(key)) continue;

    const delegate = client[key] as { findMany?: ...; count?: ... } | null;
    // 只挂模型 delegate(带 findMany);其余实例属性跳过
    if (!delegate || typeof delegate !== "object" || typeof delegate.findMany !== "function") continue;

    const queryModel = async (criteria: Record<string, unknown> = {}) => {
      const args: Record<string, unknown> = {
        where: sanitizeArg(criteria.where),
        orderBy: sanitizeArg(criteria.orderBy),
        take: clampLimit(criteria.limit),
      };
      // ... skip / findMany / toPlainValue
    };
    if (typeof delegate.count === "function") {
      queryModel.count = async (criteria) => delegate.count!({ where: sanitizeArg(criteria.where) });
    }
    query[key] = queryModel;
  }
  return query;
}
注意 4 条白名单纪律:
- 方法白名单只有
findMany与count——findFirst、findUnique、aggregate、groupBy、create、update、delete、upsert、$queryRaw、$transaction全部不挂。这是反直觉的取舍:业务灵活性与攻击面往往成正比,而扩展到findFirst仅仅是把 findMany 的第一条抽出来,看似无害,却给"按特定索引绕过 where 过滤"留了入口。我们宁愿业务人员多写一行await query.billRows({...}).then(r => r[0])也不开findFirst。 - 模型白名单 = 全量 - denylist——除了
user / appKey / systemSetting这 3 个模型,其他模型(BillRow、SupplyOrder、IncomePlan、ExpensePlan、AccountingItem、Bom 等业务核心表)都对脚本开放。这是 denylist 思路:业务模型全部默认开放,凭据类模型全部默认关闭。denylist 只有 3 条,比 allowlist 维护成本低 90%。 $与_前缀的方法/字段直接跳过——$queryRaw、$transaction、$executeRaw是 Prisma 内部方法,绝不能给用户;_开头的是私有字段,同样跳过。- 只挂"有 findMany 方法"的实例属性——这一条把 Prisma Client 的元数据属性(如
_engineConfig、$metrics)自动过滤掉了。
把 4 条纪律叠加起来,得到一个非常干净的沙箱 query:业务模型能查、只读、能查多少有 clamp 兜底、凭据模型彻底屏蔽。
3.1 凭据类模型为什么必须 denylist
3 条 denylist(user、appKey、systemSetting)看起来简短,但每一条背后都是真实的攻击/失误场景:
| 模型 | 如果不屏蔽会发生什么 | 真实风险 |
|---|---|---|
user | query.user.findMany({}) 拿到全部用户表的密码哈希、邮箱、手机号 | 用户隐私泄露 + 撞库风险 |
appKey | query.appKey.findMany({}) 拿到全部第三方系统接入密钥(含金蝶 HMAC 密钥、聚合结算对账 API 密钥) | 第三方系统被攻击,损失不可逆 |
systemSetting | query.systemSetting.findMany({}) 拿到数据库连接串、Redis 密钥、JWT Secret | 主进程凭据泄露,等同整库被脱 |
这 3 条 denylist 的共同特征是:"看不见的比能看见的更危险"。BillRow 即使被业务脚本全量拉走,最坏后果是「多查了几行账单」,对账结果错了可以被重跑;而 appKey 表只要泄露一行,整个第三方集成体系立刻不可信。这种"看不见的钥匙"才是真正的攻击面。
3.2 clampLimit:500/2000 是怎么定的
clampLimit 函数把 limit 参数强制夹在 [1, 2000] 区间,默认 500:
const QUERY_DEFAULT_LIMIT = 500;
const QUERY_MAX_LIMIT = 2000;

export function clampLimit(v: unknown): number {
  const n = typeof v === "number" ? v : typeof v === "string" ? parseInt(v, 10) : NaN;
  if (!Number.isFinite(n) || n <= 0) return QUERY_DEFAULT_LIMIT;
  return Math.min(Math.floor(n), QUERY_MAX_LIMIT);
}
500 默认值是怎么来的?生产环境的 P95 性能基线(10 行 < 2s / 500 行 < 10s / 1200 行 < 30s 三档压测数据)告诉我们一个事实:单次沙箱调用如果返回 500 行,Prisma 查询 + toPlainValue 序列化 + IPC 传回父进程总耗时约 800ms-1.2s。如果默认到 1000 行,单次调用成本翻倍,沙箱总耗时翻倍,BullMQ Worker 的并发窗口会被撑爆。如果默认到 200 行,业务人员「我就想查全量」的口子又堵了。500 是「够用 + 兜底」的折中点。
2000 上限是兜底——即使业务脚本显式传 limit: 99999,clampLimit 也只放过 2000 行。这条防线的真实敌人是写循环调用的业务脚本(每轮 limit: 500,循环 100 轮拉 5 万行)。clampLimit 让每一轮都被夹在 2000,攻击者必须跑 25 轮以上才能凑齐 5 万行——这套循环代码本身就会触发沙箱 60 秒超时整批失败。这就是「clampLimit + 沙箱超时」的双重兜底。
四、命名助手:把 90% 的业务查询从 12 行降到 3 行
通用查询虽然开放了 BillRow、SupplyOrder 等模型,但业务人员写 80% 的对账脚本时都在问同一类问题:「这个店铺这个账期下的账单行有哪些?」——这个查询至少要写 12 行:
// 通用查询:业务人员需要写的 12 行
const bills = await query.bill.findMany({
  where: { platform: "JD_POP", shopId: shop.id },
  select: { id: true },
});
const validBillIds = bills.map((b) => b.id);
const allRoutes = getBillRowDelegatesByPlatform(prisma, platform);
const allRows = [];
for (const route of allRoutes) {
  const rows = await route.delegate.findMany({
    where: { shopId: shop.id, billId: { in: validBillIds } },
    take: 500,
  });
  allRows.push(...rows);
}
看这 12 行干了什么:先查 bills 拿有效账单 id,再遍历所有平台下的 BillRow 模型,按 shopId + billId 过滤。这套逻辑每个对账脚本都要写一遍,复制粘贴率 100%。
如果团队正在走"内部 RPC 接口封装"的路,每条业务逻辑都要再走一遍接口评审——研发排期成为业务灵活性的天花板。轻易云智能对账系统的沙箱 query 模块给另一条路:业务脚本直接在沙箱里查数据库,靠 denylist + 白名单 + 命名助手 + 出参净化四道边界保证安全,研发不需要为每条新逻辑单独开口子。
命名助手就是为这种"高频但繁琐"的查询准备的——
4.1 billRows:强制绑定店铺 + 有效账单
// common/sandbox-query.ts(节选)
billRows: async (criteria: Record<string, unknown> = {}): Promise<unknown[]> => {
  const ctx = requireContext(context);
  const client = getSandboxPrisma();
  // 一次性查全店铺下的有效账单 id(同沙箱内缓存,避免每单重复查)
  const validBillIds = await getValidBillIds(client, ctx);
  // 平台 → BillRow 模型路由(京东 POP 可能有 3 类账单,每类独立表)
  const routes = getBillRowDelegatesByPlatform(client, ctx.platform as PlatformEnum);
  // 遍历路由,统一过滤 shopId + billId in validBillIds
  for (const route of routes) {
    if (wantedTypes.size > 0 && !wantedTypes.has(route.billType)) continue;
    const where = { shopId: ctx.shopId, billId: { in: validBillIds }, ... };
    const rows = await route.delegate.findMany({ where, take: limit });
    // ...追加到 out
  }
}
几个关键设计点:
requireContext(context)强制要求计划上下文——context必须含platform + shopId,否则直接抛错("沙箱缺少计划上下文(context),无法执行数据查询")。这意味着脚本不能脱离具体计划查全表,连"我先看看整个系统的账单长什么样"都不允许——对账脚本永远是「在某个具体计划下工作」。shopId = ctx.shopId强制锁定——业务脚本写billRows({ businessOrderNo: "X" })时,where 子句被自动加上shopId = ctx.shopId。脚本即使想"跨店铺偷看"也偷不到。billId: { in: validBillIds }有效账单过滤——bills表被删除/重置时,会留下"孤儿" BillRow 行(billId 指向已不存在的账单)。这些孤儿行曾污染对账抵扣合计(2026-09-03 真实事故)。命名助手强制只取有效账单下的行,把这个隐患免疫掉。- 返回行附加
table / billType字段——业务脚本拿到一行时能直接判断"这是京东 POP 营销对账表的营销券行,还是结算账单的退款行",不用再 join 元数据。
把 12 行的通用查询压缩成命名助手调用:
// 业务人员用命名助手:3 行搞定
const rows = await query.billRows({
  billType: "marketing_reconcile",
  businessOrderNos: ["123456"],
});
// rows[0].billType === "marketing_reconcile"
// rows[0].table === "jd_pop_marketing_reconcile"
业务人员的代码量从 12 行降到 3 行,更重要的是他没有机会写出不带 shopId 过滤的 where——错在结构上就被避免了。
4.2 supplyOrders 与 supplyChannelOrders:v6 拍扁的对外接口
供应链订单在 v6 一维拍扁(每行 = SKU 明细)后有 7 张相关表(supply_orders 主表 + supply_orders_1 到 supply_orders_6 渠道表),命名助手把这种"散在多表但查询模式一致"的场景统一封装:
// supplyOrders: 查主表(最常用)
const orders = await query.supplyOrders({
  businessOrderNos: ["B001", "B002"],
  customerCode: "C001",
});

// supplyChannelOrders: 查渠道表(按 channel: 1-6 路由)
const jushuitanOrders = await query.supplyChannelOrders(1, {
  businessOrderNos: ["B001"],
  documentStatus: "已发货",
});
supplyChannelOrders 的 channel 参数必须是 1-6 的整数,传 7 或字符串立刻抛错。这条约束来自 v6 拍扁的"6 张渠道表"硬边界——业务人员永远不需要第 7 张表。
五、4 类沙箱共用一份 sandbox-query.ts
沙箱 query 不是某一类沙箱的私有能力,而是parse / reconcile / allocate / transform 四类沙箱共用。我们看 4 类沙箱宿主(runner 文件)的注入点:
| 沙箱 | 注入位置 | 命名助手 context 来源 |
|---|---|---|
| Parse | parse-scripts/sandbox-runner.ts | input.context(父进程从账单注入 platform + shopId) |
| Reconcile | reconcile-scripts/reconcile-sandbox-runner.ts | input.context |
| Allocate | expense-plans/allocate-sandbox-runner.ts | input.context |
| Transform | transform/transform-sandbox-runner.ts | input.input.scope(脚本入参里的 platform + shopId) |
注入的代码模式高度一致:
// 四类沙箱都这样注入
query: {
  ...buildGenericQuery(),                              // 通用查询(白名单 + denylist)
  ...buildNamedQueryHelpers(input.context),            // 命名助手(依赖 context)
}
唯一差异是 transform 沙箱的 context 从 input.input.scope 取——因为 transform 没有「当前在处理哪行账单」的概念,它的上下文是「整个批次(platform + shopId + periodFrom + periodTo)」。这是 v6 一维拍扁的体现:对账脚本按行处理(context = 当前行所在账单的 platform + shopId),转换脚本按批次处理(context = 整个批次的 scope)。
共用一份实现的好处有三:
- denylist / 白名单只在一处维护——新增一个敏感模型,只要在
GENERIC_QUERY_DENYLIST里加一行,4 类沙箱同步生效。 - clampLimit / toPlainValue 行为一致——业务脚本在 4 类沙箱里看到的
limit默认值、出参格式完全一致。 - bug 修复一处生效——比如 Decimal 判定逻辑在生产环境被发现有边界问题(见下文「toPlainValue:为什么不能用
instanceof Decimal判定」小节),修复一次 4 类沙箱同时受益。
六、出参净化:toPlainValue 与 sanitizeArg 的两个反直觉细节
沙箱 query 的出参与入参各自要过一道净化器,这两道净化藏着两个反直觉细节。
6.1 toPlainValue:为什么不能用 instanceof Decimal 判定
业务数据从 Prisma 查出来时,金额字段是 Decimal 实例(来自 decimal.js),日期字段是 Date 实例。这两种类型跨 V8 Context 边界时结构不变但原型链可能丢失,必须序列化成「纯数据」才能跨 IPC 安全传回父进程。
朴素的实现是 JSON.parse(JSON.stringify(value)),但这把 Date 变成 ISO 字符串(好),把 Decimal 变成数字(糟——Decimal(20, 4) 精度会被截断成 Number 精度,财务数据就废了)。
所以需要 toPlainValue 显式处理:
export function toPlainValue(v: unknown): unknown {
  if (v === null || v === undefined) return null;
  if (v instanceof Date) return v.toISOString();
  if (typeof v === "object") {
    const ctor = (v as { constructor?: { name?: string } }).constructor?.name;
    // Decimal 判定不能依赖 constructor.name:生产构建 minify 后类名退化为短标识(实测 'i'),
    // 且 Prisma 内联打包的 Decimal 与 decimal.js 包非同一份(instanceof 失败)。
    // 用 decimal.js 实例结构签名(d: number[] / e: number / s: number + toFixed)做鸭子类型兜底。
    if (ctor === "Decimal" || (
      typeof (v as { toFixed?: unknown }).toFixed === "function" &&
      Array.isArray((v as { d?: unknown }).d) &&
      typeof (v as { e?: unknown }).e === "number" &&
      typeof (v as { s?: unknown }).s === "number"
    )) {
      return (v as { toString(): string }).toString();
    }
    if (Array.isArray(v)) return v.map(toPlainValue);
    const out: Record<string, unknown> = {};
    for (const [k, val] of Object.entries(v as Record<string, unknown>)) out[k] = toPlainValue(val);
    return out;
  }
  return v;
}
头注释里那段话值得反复读——生产构建 minify 后 constructor.name 退化为单字符 'i'。如果按 dev 模式写 ctor === "Decimal",生产环境会失效,Decimal 走通用对象处理,结果 Decimal(100.50) 变成 { d: [...], e: 0, s: 1 } 的原始结构,金额精度丢失。
解决方案是鸭子类型兜底:decimal.js 的实例必然有 d: number[](尾数数组)、e: number(指数)、s: number(正负号)+ toFixed 方法。这四条全命中,就是 Decimal 实例。不依赖类名,不依赖 instanceof——这是经过生产环境踩坑才得出的反直觉经验。
6.2 sanitizeArg:原型链攻击的防御
业务脚本通过 where 参数传给 Prisma 的过滤条件本身就是个 JSON 对象——理论上业务脚本可以在这个对象上挂 getter:
// 业务脚本里的恶意(或误写)代码
const evilWhere = {
  shopId: "JD_POP-SHOP-001",
  get createdAt() {
    // 每次 Prisma 读取 createdAt 都触发这个函数
    throw new Error("Prisma 内部崩溃");
  },
};
await query.billRows({ where: evilWhere });
这种攻击看上去人畜无害(顶多让查询失败),但Prisma 在 where 参数上挂访问器会干扰它的内部取值逻辑——Prisma 内部要遍历 where 的所有键来决定生成哪条 SQL,挂个 getter 会让内部循环不可预测。更糟的是,沙箱里的脚本对象原型与宿主不同,where 对象可能跨边界时丢失原型导致 Prisma 抛 Cannot read property of undefined。
sanitizeArg 用最朴素的 JSON 往返 stripping 掉原型:
function sanitizeArg(v: unknown): unknown {
  if (v === null || v === undefined) return undefined;
  return JSON.parse(JSON.stringify(v));
}
JSON.stringify 把对象转为字符串时只保留可枚举属性、不触发 getter、不保留原型;JSON.parse 反序列化得到一个干净的 {}。这条防线代价是 where 不再支持 Date(会被转成 ISO 字符串,Prisma 不能识别)和正则(被转成 {}),但业务脚本里的 where 几乎不需要这两种类型——这是可以接受的代价。
七、生产真实使用:京东 POP 集成转换脚本里的 6 处 query.billRows
理论上的白名单 + 命名助手要落到生产代码里才有用。轻易云智能对账系统的京东 POP 集成转换脚本里,仅「营销券差异判定」这一段业务逻辑就调用了 6 次 query.billRows,分布在 6 个差异标签(diffReason)的判定分支里——下面展示其中一段:
// 营销券差异判定(v1.2.0 起,业务定稿)
if (item.diffReason === "MARKETING_COUPON_DIFF") {
  var mkRows = await query.billRows({
    billType: "marketing_reconcile",
    businessOrderNos: [item.businessOrderNo],
  });
  var selfAmount = new Decimal(0);
  var lijianAmount = new Decimal(0);
  for (var ki = 0; ki < mkRows.length; ki++) {
    var couponType = String((mkRows[ki].rawData && mkRows[ki].rawData["优惠类型"]) || "");
    var couponAmt = new Decimal(mkRows[ki].incomeAmount || "0").abs();
    if (couponType === "联合按比例承担优惠劵-自营") selfAmount = selfAmount.plus(couponAmt);
    else if (couponType.indexOf("立减") >= 0) lijianAmount = lijianAmount.plus(couponAmt);
  }
  // ... 按 labelParts 分别出「自营」「立减」两张单据
}
业务语义是这样的:当对账脚本识别一条 MARKETING_COUPON_DIFF(营销券差异)标签时,集成转换脚本要查这个业务订单号下的所有营销对账行,按「联合按比例承担优惠劵-自营」和「立减」两类分别汇总,然后分别出两张费用应收单——这是京东 POP 集成转换 v1.2.0 的关键业务规则。
如果沙箱 query 没提供 billRows 命名助手,这个判定要么写 12+ 行的通用查询(且容易漏掉有效账单过滤),要么由父进程预查传进来(增加 IPC 通信成本)。命名助手让"按业务订单号 + 账单类型查 BillRow"成为对账脚本和转换脚本的原子能力——业务规则升级时改的是语义层,不会被查询技术烦恼。
下面是 AI 财务智能体在自动解析场景下使用沙箱 query 的典型路径:

注意第 4 步「AI 智能体自动勘察」——AI Agent 在编写脚本时需要查 getBillSampleRows 等工具,这些工具本质上都是沙箱 query 的封装。如果沙箱 query 不安全,AI Agent 写的脚本就不安全;如果沙箱 query 不够用(白名单太严),AI Agent 就写不出复杂对账逻辑。沙箱 query 是 AI Agent 安全感的来源,也是 AI Agent 能力的天花板。
八、边界设计的 3 条代价
这套设计在生产环境跑了一年以上,每天稳定支撑 4 类沙箱的并行调用,喂得起 1200 行的账单 + 800 个供应链订单的交叉查询。但它有 3 条真实代价:
代价 1:通用查询只有 findMany/count——业务灵活性被牺牲。findFirst 看似无害,但不开放这条换来的是「脚本不能绕过 where 过滤索引」。aggregate / groupBy 不开放,业务脚本做统计只能循环累加——一个 1000 行的聚合可能要跑 1 秒。但这条代价换来了「沙箱 query 的攻击面 = 几乎只有 N+1 查询」——可预测、好监控、好兜底。
代价 2:denylist 模型彻底不可见——业务人员无法 debug「某个系统账号到底是哪个 user」。但这条代价换来了「凭据类模型没有泄露路径」——安全优先级高于调试便利。
代价 3:clampLimit 2000 上限——业务人员一次性查不了 5000 行。但这条代价换来了「单次沙箱调用 < 1.5s 的 P95 性能基线」。需要 5000 行的业务脚本可以分页(skip 参数已开放),但前提是它有分页语义——账单按账期分页、对账按业务订单号分页、供应链订单按客户编码分页。
这 3 条代价的共同主题是:为了安全主动放弃的能力,是这套设计最大的价值。
最后用一张价值图把整篇文章的核心张力画出来:
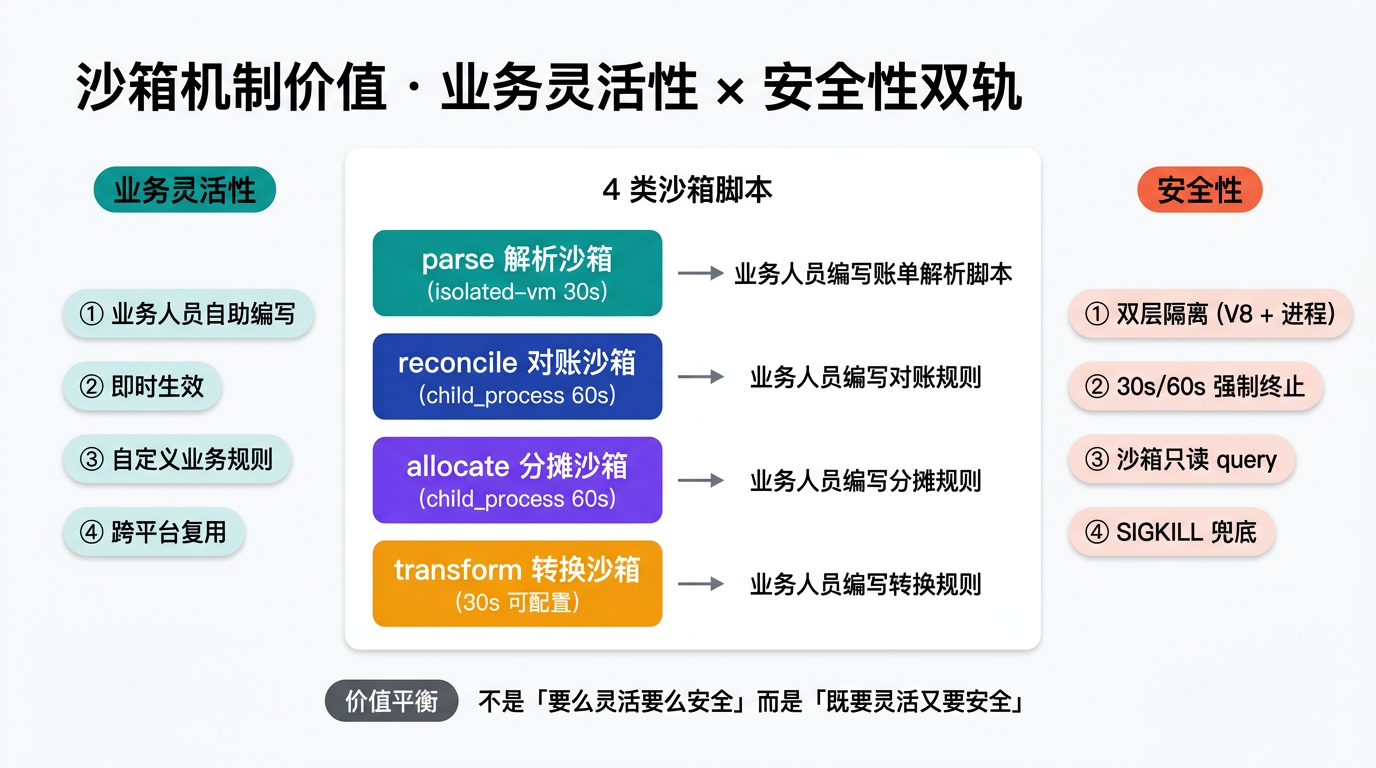
这张图把"沙箱 query"在 4 类沙箱脚本中的角色画清楚了——parse / reconcile / allocate / transform 共享同一个 query 出口,每个沙箱的边界(超时常量、注入位置)独立可调。沙箱 query 是 4 类沙箱的"共用数据层",而 denylist + 白名单是这套共用数据层的纵深防御。业务灵活性的来源是 query 提供的丰富方法(命名助手 + 通用查询),安全性的来源是 denylist + clampLimit + toPlainValue + sanitizeArg 这 4 道后防线。
九、收尾
回到文章开头的那个尴尬:
业务人员想在沙箱里查数据,又不能让他改数据。
在轻易云智能对账系统的工程实践中,这道题的答案不是「全开」也不是「全关」,而是「按业务模型 + 受控方法 + 上下文绑定 + 出参净化」四道边界同时划线。
沙箱 query 的答案不是「全开」也不是「全关」,而是「按业务模型 + 受控方法 + 上下文绑定 + 出参净化」四道边界同时划线。findMany/count 是白名单、user/appKey/systemSetting 是 denylist、billRows/supplyOrders/supplyChannelOrders 是命名助手、clampLimit 500/2000 是性能兜底、toPlainValue 是序列化净化、sanitizeArg 是原型链防御——这 6 道边界叠加,才换来「业务人员查得到必要的数据,恶意脚本查不到危险的字段」这个平衡点。
这套设计的真正价值不在于它今天撑起了多少业务,而在于它用 235 行代码同时回答了两个互相矛盾的需求:
- 业务人员:我需要
BillRow、SupplyOrder、AccountingItem、IncomePlan、ExpensePlan的全量查询能力,最好不要让我写 12 行过滤,最好不用我记哪个模型叫什么字段。 - CTO / 安全工程师:我需要
user、appKey、systemSetting这 3 张表从沙箱里彻底消失;我需要脚本不能写、不能findFirst绕过索引、不能挂访问器干扰 Prisma、不能单次拉 5 万行把 PG 打爆。
沙箱 query 的设计就是把这两个诉求同时实现。
如果你正在评估对账系统的脚本能力,除了问"你们的沙箱 SIGKILL 是哪一层做的"(参考上一篇文章),再多问一句:"你们的沙箱 query,denylist 有几条?"——答不出 3 条(user / appKey / systemSetting)或答不出"凭据类模型整张屏蔽"的,说明白名单没做纵深防御。
沙箱 query 的边界即对账系统的边界:能查什么,就只能算什么;不能查什么,就永远不能算什么。这条边界划得越清楚,对账系统的能力就越可预测。
延伸阅读
parse-script-developmentskill:解析脚本契约(export default parse、1s 编译期超时、试跑端点 30s 闸)与本篇 query 边界的关系reconciliation-script-developmentskill:对账脚本(reconcile)的差异标签码(23 个)与命名助手 billRows 的协同判定逻辑integration-transform-script-developmentskill:集成转换脚本(transform)的批次级执行与 context 上下文传递约定