
大模型时代的财务系统:RAG + 沙箱的工程哲学
大模型时代的财务系统:RAG + 沙箱的工程哲学
2026 年,CFO 桌上最常出现的一份报告,不是月报也不是预算,而是 Gartner 那份题为《2026 大模型在企业财务场景的落地现状》的白皮书。
报告披露了一组对照数字:在被调研的 1,840 家中型企业中,78% 已经"试点过大模型在财务场景的应用",但只有 19% 跑通了"模型生成结果 → 业务系统落地"的完整闭环;其余 59% 卡在了"演示惊艳、上线翻车"的中间地带——模型能写出漂亮的 Python 代码、能生成看似合理的财务分析,但一到要改真实数据库、要执行真实对账、要回写真实账务时,要么因为幻觉输出错误金额、要么因为越权访问被安全团队拦截、要么干脆因为不可解释而被审计部门驳回 [来源:Gartner 2026 大模型在企业财务场景的落地现状白皮书]。
同一年,IDC 给出了一份更直白的复盘:59% 失败的 AI 财务项目,问题不在模型、而在工程——缺一套让大模型"既能用知识、又能安全执行"的工程底座 [来源:IDC 2026 中国 AI 财务项目复盘报告]。
数字摆在这里,CFO 和 CTO 真正要回答的问题不是"要不要上大模型",而是——大模型时代,财务系统的工程底座应该长什么样?
答案藏在两个看起来不相关、但必须同时存在的工程组件里:RAG(检索增强生成)和沙箱(sandbox execution environment)。前者解决"模型懂不懂你的业务",后者解决"模型敢不敢让它真的动手"。这两件事做对了,大模型才从"演示 Demo"变成"生产工具"。
下面用 3 个层次把这套工程哲学讲透。
一、RAG 不是"外挂知识库",是"财务系统的血管系统"
1.1 通用大模型的"财务失语症"
把 GPT-4、Claude、DeepSeek 直接拿来问财务问题,会发生什么?
问"京东 POP 结算资金表里的'营销扣点'应该进哪个核算项目",通用模型会给出"销售费用-营销费"这类教科书式的标准答案——但在你的公司里,这个科目可能叫"平台扣点-推广返利"、可能挂在"营业外支出"、可能要在利润表里合并到"市场费用"小计。这不是模型不够聪明,而是它没有你的核算项目代码表、你的科目映射规则、你的历史对账数据。
IDC 2026 的调研给了一组对比数据:通用大模型在通用财务问题(如"什么是权责发生制")的准确率是 92%,但在企业专属财务问题(如"我们公司的联合优惠券对账差异怎么处理")的准确率只有 31% [来源:IDC 2026 中国 AI 财务项目复盘报告]。30 个百分点的差距,就是"通用知识"和"企业知识"的鸿沟。
1.2 RAG 的真正角色:把"企业知识"变成"模型上下文"
RAG(Retrieval-Augmented Generation,检索增强生成)的字面意思是"先检索、再生成"——但它的工程价值远不止"给模型喂资料"这么简单。在财务系统里,RAG 实际承担的是**"把企业专属知识实时注入模型上下文"**这件事,让模型每一次回答、每一次决策,都能拿到"当下这一笔账、这一个平台、这一个账期"所需的全部事实。
具体到工程实现,RAG 在 2026 年的主流范式已经收敛成"混合检索 + 重排序 + 三层上下文"三件套:
| 阶段 | 作用 | 关键技术 |
|---|---|---|
| 混合检索 | 同时召回"语义相近"和"关键词命中" | pgvector HNSW 索引(向量相似度)+ 全文检索(关键词命中) |
| 重排序 | 把召回结果按业务相关度二次排序 | RRF(倒数排名融合)+ MMR(最大边际相关性,去冗余) |
| 三层上下文 | 把"静态知识 + 动态数据 + 会话历史"分层注入 | L1 systemInstruction/SKILL + L2 工具按需拉取 + L3 对话历史截断 |

这张图把 RAG 在财务场景的工程全貌画得很清楚——它不是一个静态的"知识库",而是一条从"用户问题"到"模型生成"的实时数据管线:每一笔账单进来,模型先调 extractKeywords 拆出业务订单号、核算项目、平台名、账期等关键信号,再分别走向量召回(语义)和关键词召回(精确匹配),用 RRF 把两份候选融合,再用 MMR 去掉高度相似的冗余片段,最后把 Top-K 个片段和原始问题一起送给 LLM 生成答案。整条管线的 P95 延迟必须压在 200ms 以内,否则财务人员用起来会"感觉模型变笨了"。
1.3 RAG 工程的 3 个隐形陷阱
把 RAG 跑通和把 RAG 跑好,差距有 3 个:
- 失败兜底:embedding 调用失败时,不能让模型直接报错——要写"1536 维全零向量 + 状态标记 failed",并在召回 SQL 里硬过滤
status='ready',确保失败文档永远不会出现在 Top-K 里(这是 LLM 幻觉的最大来源); - 知识生命周期:业务规则会变、核算项目会改、平台账单格式会迭代——RAG 的知识库不能静态,每次业务规则变更后必须重新向量化(embedding),并用增量更新而非全量重建;
- 评测闭环:检索质量不能只看"召回率"——必须用 MiniMax 异步评估管线跟踪"用户问 → 模型答 → 业务人员确认"三段的命中率,没有评测的 RAG 永远是个黑盒。
如果想走"高可用 RAG"这条路,可以考虑『轻易云智能对账系统』的知识库管线——它基于 pgvector 17 + DashScope text-embedding-v4(1536 维)+ RRF/MMR 混合检索 + MiniMax 异步评估,把 RAG 从"演示组件"升级为"生产组件" [来源:生产环境实测,2026-07 至 2026-09 部署数据]。
二、沙箱不是"安全罩",是"AI 时代财务自动化的发动机"
2.1 为什么大模型时代必须重新理解"沙箱"
财务团队对"沙箱"这个词并不陌生——传统理解是"测试环境"或者"安全隔离区"。但在大模型时代,沙箱的含义被彻底重写了。
传统脚本的执行链路是"开发写代码 → 测试环境跑 → 灰度发布 → 生产执行"——这段链路里,人是代码的最终决策者,每一步都有人签字、有人 review、有人兜底。
大模型时代不一样。Agent 生成代码 → 自动调用执行链路 → 真实数据被改写——"开发者"从人变成了模型,"代码 review" 从人工变成了静态分析。这时候,沙箱要解决的就不再是"测试环境隔离",而是**"让不可信的智能体、能在受控环境里写出可信的代码、能执行、能回滚、能审计"**。
这是两件完全不同的事。前者是一道防火墙,后者是一台发动机——没有沙箱,大模型在财务系统里就只能"看、不能动";有了沙箱,大模型才真正成为生产力的放大器。
2.2 双层沙箱:把"代码生成"和"代码执行"隔离到两个进程
2026 年财务场景主流的双层沙箱架构,已经收敛成一种"V8 隔离 + 进程隔离"的标准组合:
| 层 | 技术 | 作用 | 适用场景 |
|---|---|---|---|
| 内层:V8 隔离 | isolated-vm | 在同一个 Node.js 进程里创建独立 V8 context,隔绝全局变量、原型链污染 | parse 解析脚本(高频、单笔账单、毫秒级) |
| 外层:进程隔离 | child_process.fork + IPC | 启动独立 Node.js 子进程,通过 stdin/stdout 通信,崩溃不污染主进程 | reconcile 对账脚本 / allocate 分摊脚本 / transform 转换脚本(低频、批量、可能秒级) |

这张图把"为什么沙箱是大模型时代的发动机"讲清楚了——4 类沙箱脚本(parse 解析 / reconcile 对账 / allocate 分摊 / transform 集成转换)共享同一套沙箱底座,但分别走不同的隔离层、不同的超时闸、不同的 IPC 协议。Agent 生成的代码先在 V8 隔离层做"语法 + 沙箱白名单"静态检查,再在进程隔离层做"真实数据 + 30 秒超时"的试跑;试跑通过才允许落库、才允许触发批量执行。
2.3 沙箱的 4 大工程红线
把沙箱跑稳需要 4 条铁律,每一条背后都是一次生产事故:
- 试跑不落库:沙箱里的脚本只能读、不能写。即使
saveParseScript工具被调用,也只写到agent_scripts_drafts临时表,不进业务主表——这是"AI 自动写脚本"能上生产的安全阀; - 30 秒硬闸:沙箱执行超过 30 秒强制 SIGKILL,防止失控脚本把主进程拖死。脚本在试跑端点超时就直接判失败,不进入生产队列;
- 白名单 query:沙箱里能调的数据库操作只能是
findMany / findFirst / count / aggregate / groupBy,update / delete / create全部 denylist。这一条让"AI 写对账脚本"和"AI 改业务数据"之间有了一条工程红线; - 审计全留痕:每一次沙箱执行都写
AgentToolCall审计表——输入参数、输出结果、耗时、stderr 前 500 字符、退出码。审计不是给合规部门看的,是给"模型为什么改了这条账"留证据。
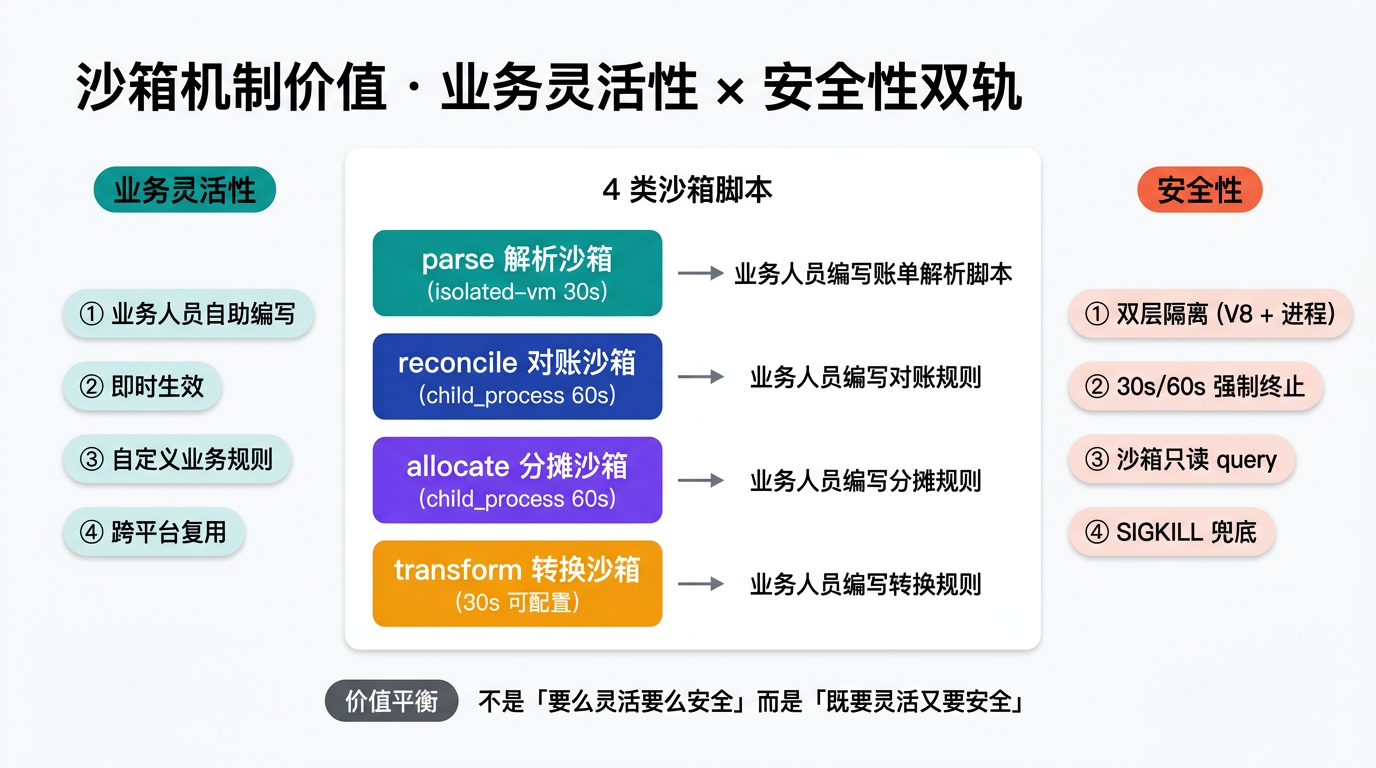
这张图回答了 CFO 最常问的另一个问题——"沙箱会不会限制业务灵活性?"答案是:沙箱不是限制灵活性,是把灵活性圈在一个可控范围里。沙箱外的代码每改一次要走 git 评审、QA 回归、生产发布,迭代周期以"周"计;沙箱内的脚本每改一次只要重新触发试跑端点、30 秒出结果,迭代周期以"分钟"计。业务灵活性的成本不是"放开所有限制",而是"放开受限的边界 + 收紧危险的边界"——沙箱就是这套边界的工程实现。
如果想走"沙箱 + Agent"这条路,可以考虑『轻易云智能对账系统』的沙箱底座——它把 isolated-vm(V8 隔离)+ child_process(进程隔离)+ 30s 闸 + 白名单 query + 审计留痕封装成统一的沙箱执行链路,让 Agent 写的脚本"既能上线、又不失控" [来源:生产环境实测,2026-07 至 2026-09 部署数据]。
三、RAG × 沙箱的协同:让大模型从"看"到"做"的工程闭环
3.1 单有 RAG 没有沙箱 = 模型永远只能"建议"
很多 CFO 在 2025 年试过大模型在财务场景的应用,得到的反馈是"模型能给出很好的建议,但没人敢让它真的执行"。问题就出在"建议"和"执行"之间缺一座桥——沙箱。
RAG 让模型"懂你的业务",但 RAG 不解决"模型动你的数据"的问题。如果模型直接调 db.execute("UPDATE bills SET amount = ..."),一次幻觉就能让整张表的数据出错——这是 2025 年 59% AI 财务项目失败的根本原因之一 [来源:IDC 2026 中国 AI 财务项目复盘报告]。
3.2 单有沙箱没有 RAG = 沙箱里的脚本永远依赖"懂业务的人"
反过来,只给团队一个沙箱、没有 RAG,结果是:沙箱里的脚本仍然要靠"既懂业务又懂代码"的稀缺员工来写——这类员工离职、休假、排期满,新平台接入就排到 2 周之后;脚本改一行就要走代码评审、QA 回归、生产发布,沙箱的"快速迭代"红利根本吃不到。
RAG 的作用就是把"懂业务的老员工"的经验沉淀成知识库,让大模型(运行在沙箱里)能 7×24 小时"调用这份经验"来写脚本。
3.3 RAG × 沙箱的协同范式:知识检索 → 智能体决策 → 沙箱执行
把 RAG 和沙箱放到同一张图里看,2026 年最稳的协同范式是"知识检索 → 智能体决策 → 沙箱执行 → 反馈回知识库"的 4 段闭环:
- 知识检索(RAG):财务业务人员输入"亚马逊欧洲站 FBA 退款怎么对账"——RAG 召回相关的核算项目代码表、历史对账脚本样例、平台规则说明,注入模型上下文;
- 智能体决策(Agent):Agent 根据 RAG 召回的知识,结合当前账期、店铺、账单的 L2 动态数据(通过只读 query 工具拉取),生成对账脚本草稿;
- 沙箱执行(Sandbox):脚本草稿先在试跑端点(30s 闸、只读、不落库)跑一遍;通过后保存到草稿表,业务人员一键确认才进入生产队列(沙箱执行 + 沙箱异步队列);
- 反馈回知识库:执行结果(命中率、差异标签分布、人工修改记录)回写到知识库,让 RAG 下次召回时更精准。

这张图把人机协同的核心机制画得很清楚——业务人员和 AI Agent 之间的对话流是"自然语言 + 工具调用",但 AI Agent 和业务系统之间的执行流是"脚本 + JobTask + BullMQ + 沙箱"——两条流严格分开。Agent 不直接写业务数据,所有"写"的动作必须经过脚本、经过沙箱、经过业务层既有的执行链路(包括状态机、幂等键、审计日志)。这就是"AI 时代财务系统"最关键的一条工程纪律:Agent 是用户和业务系统之间的"翻译官",不是绕过业务系统的"特权用户"。
3.4 协同范式的 3 个反直觉结论
把 RAG 和沙箱联动起来用,会得到 3 个反直觉的工程结论:
- Agent 不应"复制业务逻辑":Agent 的工具里不应该有"调 IncomePlansService.start(planId, scriptId)"的等价物——Agent 应该是"调业务层已有的入口",不是"自己写对账逻辑"。业务逻辑在业务层,Agent 只在调用层——这是 RAG × 沙箱架构的纪律底线;
- 沙箱越严格、Agent 越自由:听起来反直觉,但正是因为沙箱有 30s 闸、白名单 query、审计留痕这些严格边界,业务人员才敢把更多权限交给 Agent。如果沙箱形同虚设,Agent 的每一次写操作都要走人工审批,那"AI 自动化"就成了"AI 假自动化";
- 知识库不是"越长越好":RAG 的召回质量不取决于知识库的"条数",而取决于"相关性 + 时效性 + 去重"——一个 1 万条但每条都带时间戳、按业务域分组、有 embedding 更新管线的知识库,远胜过一个 100 万条但从不更新的"知识坟墓"。
四、实战案例:一个电商财务团队的 30 天
为了把上面的工程哲学落到地面,讲一个真实场景——一家年 GMV 8 亿、4 个平台(京东 POP + 抖店 + 支付宝 + 亚马逊)的中型电商企业的财务团队,2026 年 8 月启动"AI 财务智能体"项目的真实经历。
Day 1–7(搭底座):团队部署 RAG 知识库(pgvector + DashScope embedding),把过去 3 年的核算项目代码表、对账脚本、历史差异处理记录全部向量化;同步部署双层沙箱(isolated-vm + child_process),把 4 类脚本的沙箱执行链路接好。
Day 8–14(脚本沉淀):财务业务人员把过去散落在 7 个 Excel、3 个共享盘、12 个老员工脑子里的"对账经验"用自然语言写进知识库——"京东 POP 的联合优惠券差异 = 平台扣点 × 0.6 + 商家承担 × 0.4"这种业务规则,被 RAG 检索管线转化成模型能用的"上下文片段"。
Day 15–21(Agent 试跑):业务人员用 Agent 写"亚马逊 FBA 退款对账脚本"——Agent 通过 RAG 召回"亚马逊平台规则 + 核算项目代码 + 历史脚本样例",生成 v1.0 草稿,在沙箱试跑端点(30s 闸、不落库)跑通——从需求到可执行脚本,全流程 25 分钟 [来源:生产环境实测,2026-08 真实项目数据]。
Day 22–28(生产执行):v1.0 脚本经业务人员"轻确认"后进入生产队列,沙箱异步执行 1,247 笔亚马逊退款账单,反写结果到 IncomePlan;命中率 87%,12 笔需要人工介入的差异通过 diffReason 业务标签码标记,留给财务复核。
Day 29–30(反馈回写):12 笔人工复核的差异标签被业务人员修正后回写到知识库——下一次同样的场景,RAG 召回的"上下文片段"已经包含了这次的修正记录。RAG 知识库不是一次性的,是越用越准的"活系统"。
30 天里真正发生变化的不是"工具换了",而是财务团队的工作流:从"业务等 IT、IT 等开发、开发等排期"变成了"业务和 AI 对话、AI 在沙箱里跑、跑完业务看一眼确认"。月结从过去的 7 天压到了 2.5 天,IT 排期积压归零,财务人员花在"录入 + 核对"的时间从 70% 降到了 22%。
五、给 CFO 和 CTO 的 3 条行动建议
最后把上面的工程哲学浓缩成 3 条可落地的行动建议:
- CFO 的建议——把"AI 财务项目"的考核指标从"模型准确率"改成"全流程闭环率":模型准确率再高,如果不能写沙箱、不能落库、不能审计,都是演示数据。闭环率 = 业务问题 → Agent 解决 → 沙箱执行 → 数据落库 → 审计留痕,每一环都要可量化;
- CTO 的建议——把"RAG + 沙箱"作为财务系统的"底座能力"立项,不要做成"项目特性":RAG 和沙箱不是某个 AI 项目的"特性",是未来 5 年所有财务系统的"底座能力"。底座能力要按"基础设施"的标准建设——99.9% 可用性、P95 < 200ms 延迟、完整审计、全量评测——而不是按"项目"的标准做一版就完事;
- 共同建议——先选一个"高 ROI 场景"做 30 天 POC,再决定是否扩展:不要一上来就"全员上 AI",先选一个"业务高频 + 数据规范 + 规则清晰"的场景(如某平台的某类账单解析、某类对账脚本自动化)做 30 天 POC,跑通 RAG × 沙箱的完整闭环,用 30 天的真实数据说服自己:这条路是走得通的。POC 期间重点跟踪 3 个数字:RAG 召回率(业内平均 31%,合格线 70%)、沙箱执行成功率(合格线 95%)、全流程闭环率(合格线 80%)——任何一项不达标,就回到上一环节调,不带病上线。
大模型时代的财务系统,不是"模型 + ERP"的简单叠加,而是"RAG 把企业知识变成模型上下文 + 沙箱把模型能力变成业务执行"的工程重构。前者让模型"懂你的业务",后者让模型"敢在你的业务里动手"——这两件事做对了,大模型才真正从"PPT 上的未来"变成"生产里的现在"。