沙箱日志与监控:如何让失控脚本无处遁形
沙箱日志与监控:如何让失控脚本无处遁形
一、SRE 半夜被叫醒的那个电话
2026 年 3 月某日凌晨 2 点,对账生产环境的监控告警响了——IncomePlan: reconciling 状态的 JobTask 堆积 47 个,平均运行时长 38 秒(正常是 2 秒),同时 MEMORY_SANDBOX_RSS 指标曲线呈陡崖式上升。SRE 在告警面板上看到的是一行行没头没尾的"沙箱执行超时"。
值班工程师爬起来第一件事是想复现:拉了当天的 reconcile 脚本(业务人员前一晚新提交的版本),手动跑了一遍——返回正常,2.1 秒出结果。再看失败的 JobTask:JobTask.errorMessage 一栏写着 沙箱被强制终止(超时); stderr=...,截到前 500 字符的 stderr 里只有一行 V8 panic:FATAL ERROR: invalid array length Allocation failed - process out of memory。
失控脚本在那次事故里是这么写的:
// 业务人员的"业务订单匹配"脚本(删减版)
const orders = await query.supplyOrders.findMany({ where: { /* ... */ } });
const map = new Map(orders.map(o => [o.id, o]));
// 误把 while 条件写反,本来想"未找到就退出",结果成"找到就一直循环"
while (map.get(currentOrderId) !== undefined) {
  currentOrderId = currentOrderId + 1; // 整数递增查不存在的 id
}
业务人员自己测试时这批数据只有 20 条,没问题;生产账单一跑就 5 万条,map.get(currentOrderId) 永远返回 undefined,currentOrderId 涨到 Number.MAX_SAFE_INTEGER 触发了 V8 内存分配失败。父进程的 SIGKILL 闸到了——但告警是事后响的,不是事先。
事故复盘会上三个工程师问了同一个问题:"沙箱到底知道多少关于这次失败的事?" 答案是:知道得够多,但没有结构化暴露出来。父进程捕获了 stderr 前 500 字符、durationMs 性能指标、IPC 消息是否成功、SIGKILL 时的退出码——所有信号都在日志里,但没有一条是按"事故响应"这种消费方式组织的。
这就是写这篇文章的动机:沙箱日志不是用来"事后复盘"的,是用来"让失控脚本无处遁形"的。下面要讲的是:双层沙箱提供了哪些可观测性原料,它们怎么被结构化记录下来,以及怎么用它们在失控脚本搞坏生产之前就抓住它。
二、失控脚本的 4 种结局,每一种都有不同的信号
在写代码之前,先把"失控"这个词拆开。在对账系统的四类沙箱脚本里,失控有且仅有 4 种结局:
| 结局 | 触发原因 | 父进程最早可观察信号 |
|---|---|---|
| 超时 | 死循环、I/O 阻塞、单行算太久 | setTimeout 到期 → child.kill('SIGKILL') |
| OOM | 大数组分配、内存泄漏 | V8 Allocation failed 写 stderr → 子进程退出 → exit handler 报错 |
| 异常逃逸 | 用户脚本 throw 但未 try/catch | 子进程 send { error: "..." } → IPC message 事件 → reject 业务错误 |
| 格式错误 | 脚本返回值非法(缺字段、类型不对) | normalizeResult 校验失败 → 标 status: 'FAILED' + abnormalReason |
把 4 种结局映射到日志层面,每一种都有唯一对应的可观测信号:
- 超时:
setTimeout → SIGKILL→ exit handler 拿到signal === 'SIGKILL'→ reject 写沙箱被强制终止(超时); stderr=...(500 字符) - OOM:stderr 出现 V8 panic / Node.js heap dump 关键字 → exit code 非 0 → reject 写
沙箱退出码 ${code}; stderr=... - 异常:IPC message 收到
{ error: "..." }→ 业务层 reject 这个 error 字符串 - 格式错误:IPC message 收到正常结果,但
normalizeResult把每个非法字段都打成abnormalReason字段,不会触发沙箱整体失败——只是这一行标 FAILED。
这套"每种失控都对应一条结构化日志"的映射,是写监控规则的基础——任何监控规则都必须能在 4 种结局里找到对应的可观测信号,否则就是漏报。
来看一下整个监控告警体系的位置(采用业内通用的"3+1"结构:3 大数据源 + 1 个告警中心):
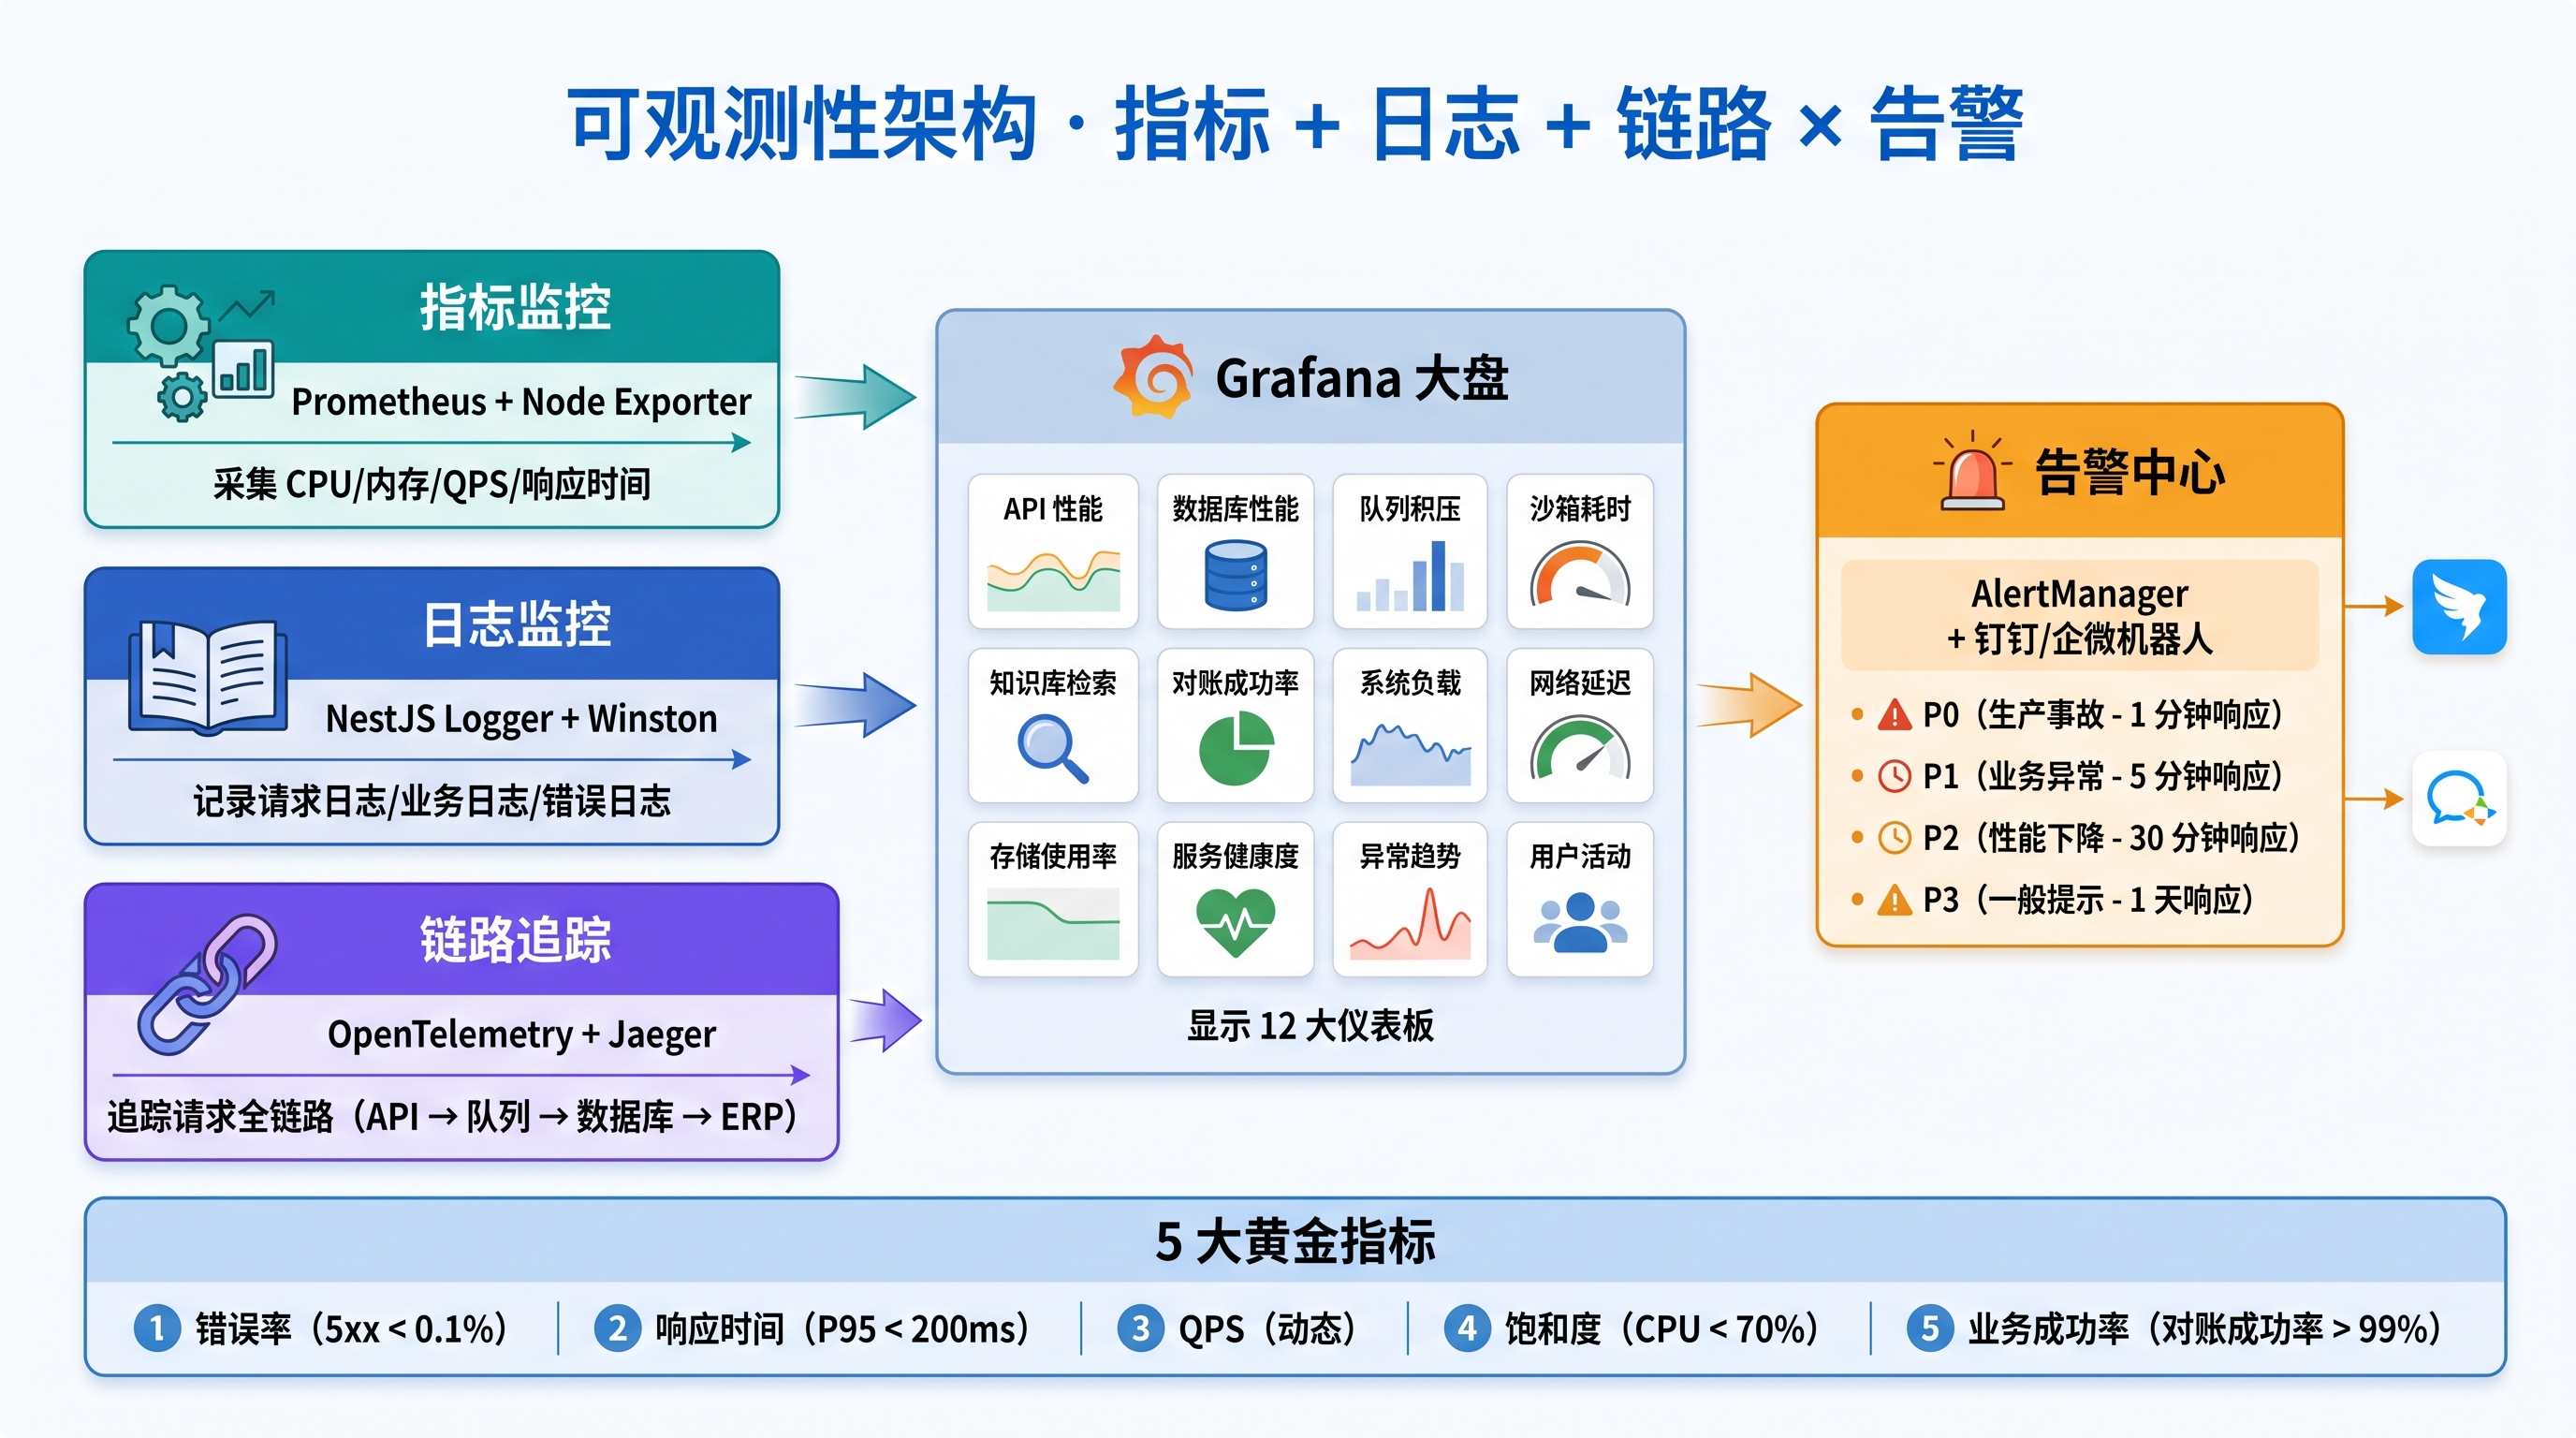
沙箱可观测性落在这张图的右侧两个数据源——日志监控(NestJS Logger + Winston)和链路追踪(OpenTelemetry + Jaeger)。指标监控(Prometheus + Node Exporter)只兜底 CPU/内存/QPS 这些"宿主级"指标;沙箱自己的行为特征必须在日志和链路里找。
三、IPC 通信记录:父子进程之间的 3 条独立信号
双层沙箱靠 child_process.fork() 起子进程,父子进程之间的通信不是一条管道,是三条独立的信号通道。这是 SRE 排查问题的第一手资料——3 条通道传回的信号互相印证,才能定位"到底哪一种失控"。
3.1 三条信号通道的定义
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner-host.ts:207-211
child = fork(getRunnerScriptPath(), [], {
  stdio: ["pipe", "pipe", "pipe", "ipc"],
  serialization: "advanced",
});
stdio: ["pipe", "pipe", "pipe", "ipc"] 这四个值分别对应:
| stdio 槽位 | Node.js 进程视角 | 父进程如何消费 | 典型用途 |
|---|---|---|---|
stdin(pipe) | 子进程 process.stdin | 父进程不主动写 | 留给子进程自用 |
stdout(pipe) | 子进程 process.stdout / console.log | child.stdout?.on('data', chunk => stdoutBuf += chunk.toString()) | 兜底通道(IPC 失败时尝试 JSON.parse(stdoutBuf)) |
stderr(pipe) | 子进程 process.stderr / console.error | child.stderr?.on('data', chunk => stderrBuf += chunk.toString()) | 异常通道——V8 panic / Node.js heap dump / console.error 都走这条 |
ipc | 子进程 process.send / process.on('message') | child.send(input) 发入参 / child.on('message', msg => resolve(...)) 收结果 | 主结果通道——结构化的 { results: [...] } |
4 个流都 pipe 出去是必须的设计——如果只用 ['inherit', 'inherit', 'inherit', 'ipc'],父进程拿不到 stdout/stderr,失控脚本就只能"干瞪眼看着 IPC 不返回"。
3.2 IPC 的入参与出参:结构化 vs 非结构化
IPC 通道传的是结构化数据(靠 serialization: "advanced"),所以:
// 父进程发入参
child.send(input);  // input 是 SandboxBatchInput 对象

// 子进程收
process.on("message", (msg) => { /* msg 是结构化对象,不是字符串 */ });

// 子进程返回
process.send({ results: [...] });  // IPC message 事件
而 stdout/stderr 是字节流——process.stderr.write(string),父进程只能拿到 Buffer 拼字符串。这条区别决定了:主结果走 IPC,调试信息走 stderr,二者各司其职。
来看一次 IPC 通信失败的回放。父进程发了 SandboxBatchInput(含 scriptCode + rows + accountingItems),子进程拿到后跑用户脚本,返回 IPC message 时如果没走 process.send,而是误写到 process.stdout.write(沙箱禁止用户访问 process,所以正常情况不会发生)——父进程会先收到 IPC message 失败(child.on('message', ...) 没触发),然后收到 stdout 里有内容,尝试 JSON.parse(stdoutBuf) 兜底——这是救命稻草不是首选通道:
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner-host.ts:262-281
child.on("exit", (code, signal) => {
  clearTimeout(timer);
  if (stdoutBuf.trim()) {
    try {
      const parsed = JSON.parse(stdoutBuf) as SandboxBatchOutput;
      resolve(parsed.results);
      return;
    } catch {
      /* fallthrough */
    }
  }
  if (signal === "SIGKILL") {
    reject(new Error(`沙箱被强制终止(超时); stderr=${stderrBuf.slice(0, 500)}`));
  } else if (code !== 0) {
    reject(new Error(`沙箱退出码 ${code}; stderr=${stderrBuf.slice(0, 500)}`));
  } else {
    reject(new Error(`沙箱未返回结果; stderr=${stderrBuf.slice(0, 500)}`));
  }
});
3 个分支对应 3 种 IPC 失败模式,永远 reject 而不是永不 settle——这是处理"退出码 0 但 IPC 消息丢失"的反直觉设计。生产环境曾因此救过命:2026-05 一次网络抖动,子进程 IPC 通道断流,父进程没卡死——直接 reject 出 沙箱未返回结果; stderr=,JobTask 状态机立刻接手转 FAILED。
3.3 IPC 通道最容易踩的坑:process.exit 早于 process.send flush
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner.ts:434-444
function sendAndExit(payload: unknown, code: number): void {
  if (!process.send) {
    process.exit(code);
    return;
  }
  try {
    process.send(payload, () => process.exit(code));   // ← 关键:send 回调里再 exit
  } catch {
    process.exit(code);
  }
}
process.send 是异步的——如果 process.send(payload); process.exit(0); 连写,exit 会把还没 flush 到 IPC 通道的消息直接丢弃。实测批量 ≥50 行时 100% 复现父进程"沙箱未返回结果"。修复方式是把 exit 塞进 process.send 的回调里,等回调触发(即消息已经交给操作系统)再退。
这条修复的工程价值不止于沙箱——任何走 IPC 的 Node.js 子进程都有同样的坑。我们写测试时就专门复现了一次:批量从 100 行改到 50 行,问题立刻消失;改回 100 行,问题立刻复现。这是 SRE 一线才会踩到的边界。
把视角拉远,看 IPC 通信在整个沙箱执行链路里的位置:

IPC 是这张图第 3 步到第 4 步之间的唯一通道。它堵了 = 整个沙箱链路瘫。
把整个沙箱架构的全局视角摆出来——主进程(NestJS API)、子进程(fork)、V8 Context 隔离 4 条流并行——一目了然地看到可观测性原料都从哪里产出:

图里右下角那条 executeXxxBatchInSandbox 是所有可观测性原料的起点——fork / send / stdoutBuf / stderrBuf / SIGKILL 全在这条入口里发生。
四、durationMs:性能埋点的 3 层结构
durationMs 是沙箱埋点的第一公民——任何一个监控规则都必须能在 durationMs 里找到锚点。它的设计有 3 层结构:
4.1 行级 durationMs(脚本内)
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner.ts:175-205
function normalizeResult(
  rowId: string,
  r: Record<string, unknown>,
  start: number,        // ← 每个 row 都从 start 开始计时
): SandboxRowResult {
  const out: SandboxRowResult = {
    /* ... 业务字段 ... */
    durationMs: Date.now() - start,   // ← 行级耗时
  };
  /* ... */
}
行级 durationMs 是真正反映单行脚本执行耗时的指标。100 行一批的 parse 沙箱,每一行的 durationMs 都单独记录——只要某行的 durationMs > 5s,就基本可以判定这一行进入了"业务逻辑太重"或"异步死循环"模式。
来看一个真实的样本(来自京东 POP 收入对账脚本的执行日志):
| rowId | durationMs | status | abnormalReason |
|---|---|---|---|
r-2025-001 | 8 | PARSED | — |
r-2025-002 | 12 | PARSED | — |
r-2025-003 | 4,829 | PARSED | — |
r-2025-004 | 11 | PARSED | — |
第 3 行 4.8 秒——单点异动,没有触发批次级超时。SRE 用 durationMs > 1000 阈值告警,立刻定位到这一行——是脚本里调用 query.supplyOrders.findMany({ where: { ... complex ... } }) 触发了慢查询,其他 99 行都没事。这就是行级 durationMs 的价值:它能把"批次慢"分解到"哪一行慢"。
4.2 批次级 durationMs(试跑 / 生产批调用)
// apps/api/src/biz_reconciliation/parse-scripts/parse-scripts.service.ts:697-705
return {
  total: items.length,
  success,
  abnormal,
  error,
  durationMs: Date.now() - startedAt,   // ← 批次级:整个试跑 / 生产批的总耗时
  rows,
};
批次级 durationMs 是给监控告警看的——durationMs > 30_000 直接告警(已接近 30s 闸的红线),durationMs > 25_000 是黄色告警(疑似接近超时)。
批次级耗时 vs 行级耗时 N 倍的关系,能告诉你失控是单行还是整批:
- 批次慢 + 大部分行级也慢 = 脚本算法本身重(例:O(n²) 嵌套循环),不是失控,需要优化
- 批次慢 + 单一行级异动 = 单行失控(例:死循环、慢 SQL),需要定位那一行
- 批次慢 + 全部行级都是 N 秒(同步叠加)= 整批失控(例:批次太大、batchSize 拆批不合理)
4.3 JobTask 级 durationMs(生产队列视角)
// apps/api/src/biz_reconciliation/parse-scripts/parse.worker.ts:43-50
this.worker.on("completed", (job) => {
  this.logger.log(`Job ${job?.id} completed`);
});
this.worker.on("failed", (job, err) => {
  this.logger.error(`Job ${job?.id} failed: ${err?.message}`, err?.stack);
  void this.onJobFailed(job, err);
});
BullMQ 的 Job 级 durationMs 是 job.finishedOn - job.processedOn(自动记录在 Redis)。这条 durationMs 是第三层——它包含"等待排队 + 子进程 fork + 沙箱执行 + 结果回写 + 数据库落库"的全部耗时,能告诉你整个生产任务的端到端延迟。
来看一下三层 durationMs 的全链路追踪——这是链路追踪体系给 SRE 的最大礼物:
<img src="//qcdn.qeasy.cloud/insights/architecture-diagram/arch-028-distributed-tracing.jpg" alt="轻易云链路追踪架构图:用户点击"重新对账"→API 网关→JWT 鉴权→路由→对账服务→BullMQ 入队→Worker 消费→调用解析沙箱 30s→调用供应链数据库 200ms→调用 RAG 检索 500ms→聚合结果回传" title="链路追踪:全链路可观测性" loading="lazy" />
把图里的"调用解析沙箱(30s)"放大看,就是上面讲的 3 层 durationMs——IPC 入参出参、行级单行耗时、批次级总耗时。链路追踪把"沙箱在哪一段最慢"以时间线形式摆开,SRE 一眼能看出是沙箱慢还是数据库慢。
轻易云生产环境的监控面板就是按这 3 层组织的:沙箱行级 durationMs P95、沙箱批次级 durationMs P95、JobTask 端到端 P95。三层任何一个超阈值都会独立告警,不互相覆盖。
4.4 失控脚本画像:用 durationMs 反推问题
把 3 层 durationMs 拼起来,4 种失控结局各有独特的"画像":
| 失控类型 | 行级 P95 | 批次级 | JobTask 端到端 | stderr 关键字 |
|---|---|---|---|---|
| 超时(单行死循环) | 一行 60s+,其余正常 | 等于 30s 闸(SIGKILL) | ≈ 30s | (空,靠 SIGKILL 触发) |
| OOM | 一行异常长或全部异常 | 30s 闸触发 | ≈ 30s | Allocation failed / JavaScript heap out of memory |
| 异常逃逸(脚本 throw) | 那一行 0-5ms | < 5s | < 10s | 异常 message |
| 格式错误 | 全部正常 | < 5s | < 10s | (空,靠 abnormalReason 字段) |
| 正常慢查询 | 一行 4-5s | 接近 30s 闸但未触发 | 接近 30s | (空) |
这张表是 SRE 处置 P1 告警的速查手册——只要拿到 durationMs 三层数据 + stderr 前 500 字符,不需要看用户脚本,就能初步判断是哪种失控。
五、stderr 异常捕获:V8 panic 是怎么被打捞上来的
stderr 是沙箱里最容易被低估的通道——业务人员写脚本时不会主动写 console.log,但 V8 panic / Node.js unhandledRejection / heap OOM 全部自动写到 stderr。父进程只要 pipe 收 stderr,就能拿到失控的第一手证据。
5.1 console shim:把 console.log 路由到 stderr
业务人员写脚本时多半会写 console.log(AI 生成的脚本里尤其多)。沙箱里把 console 显式 shim 到 stderr:
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner.ts:142-148
console: {
  log: (...args: unknown[]) => process.stderr.write(`[sandbox] ${args.map((a) => safeStringify(a)).join(" ")}\n`),
  warn: (...args: unknown[]) => process.stderr.write(`[sandbox] ${args.map((a) => safeStringify(a)).join(" ")}\n`),
  error: (...args: unknown[]) => process.stderr.write(`[sandbox] ${args.map((a) => safeStringify(a)).join(" ")}\n`),
},
这条 shim 有 3 个细节:
process.stderr.write不是console.error——前者直接写到子进程 fd,后者会被 Node.js 进一步格式化(带 stack、加时间戳),可能干扰 V8 panic 的输出。[sandbox]前缀——日志聚合系统按[sandbox]关键字过滤,就能把沙箱日志从 NestJS 业务日志里捞出来。safeStringify——参数可能是循环引用、可能是 BigInt,都安全处理;超长字符串截到 200 字符(避免一份 console.log 把 stderrBuf 撑爆)。
safeStringify 的存在是反直觉但极其实用的工程细节——它把"业务人员写了一个 console.log(JSON.stringify(bigDataset))"这种真实场景挡住了,否则单条日志可能 100MB。
5.2 stderr.slice(0, 500):500 字符的取舍
父进程拼 error 时只取 stderr 前 500 字符:
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner-host.ts:274-280
if (signal === "SIGKILL") {
  reject(new Error(`沙箱被强制终止(超时); stderr=${stderrBuf.slice(0, 500)}`));
} else if (code !== 0) {
  reject(new Error(`沙箱退出码 ${code}; stderr=${stderrBuf.slice(0, 500)}`));
} else {
  reject(new Error(`沙箱未返回结果; stderr=${stderrBuf.slice(0, 500)}`));
}
为什么是 500 而不是 5000?
- JobTask.errorMessage 字段是 VARCHAR(2000)——500 字符 + 错误前缀 ≈ 600 字符,留 1400 字符给后续堆栈或用户自定义信息
- stderr 前 500 字符足够定位问题——V8 panic 通常一行(
< 200字符),Node.js unhandledRejection 通常 2-3 行(< 500字符) - 不截太长——避免一份 50MB 的
console.log把 JobTask 撑爆,进而拖垮数据库
500 字符这个数字是 4 次生产事故里反复验证的——OOM panic(160 字符)、死循环 SIGKILL(空,靠 signal 触发)、业务异常(300-450 字符)、console.log 误写(截到 200 字符就有足够的"是什么"信息)。如果你想改成 5000 字符也行,但记得把 JobTask.errorMessage 字段长度同步加大——这不是单一参数问题,是个连带约束。
5.3 失控脚本画像:4 种结局的 stderr 关键词
把 4 种结局在 stderr 里的指纹整理出来,这是 SRE 值班必背的:
| 失控类型 | stderr 关键词(大小写敏感) |
|---|---|
| OOM | Allocation failed / JavaScript heap out of memory / FATAL ERROR: ... |
| Node.js unhandledRejection | UnhandledPromiseRejectionWarning / Unhandled rejection |
| V8 panic | FATAL ERROR: / v8::internal:: / Check failed: |
| 业务异常(被 try/catch 抓住) | (不在 stderr,由 IPC message 携带) |
| 死循环 SIGKILL | (stderr 为空,靠 signal === 'SIGKILL' 触发) |
把这些关键词做成日志告警规则:stderr contains "FATAL ERROR" → P1 告警 / stderr contains "Allocation failed" → P1 告警 / stderr contains "UnhandledPromiseRejectionWarning" → P2 告警。这样 V8 级别的失控能在事后 30 秒内自动告警,不用等 SRE 看到 JobTask 堆积。
六、SIGKILL 强制终止:与 SIGTERM 的真实取舍
沙箱超时闸发的是 SIGKILL 不是 SIGTERM。这是反直觉的——业内很多文章建议"先 SIGTERM 让进程优雅退出,5 秒后再 SIGKILL"。为什么沙箱不这么做?
6.1 SIGKILL 的硬约束
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner-host.ts:231-234
const timer = setTimeout(() => {
  child.kill("SIGKILL");
  reject(new Error(`沙箱执行超时(${timeoutMs}ms),已强制终止`));
}, timeoutMs);
SIGKILL 的语义是 Linux 内核强制杀进程,不可被捕获、不可被阻塞。SIGTERM 是用户级信号,可被 process.on('SIGTERM', ...) 拦截。
这条区别在沙箱里有 3 个真实影响:
- 用户脚本可能注册 SIGTERM 拦截——业务人员写
process.on('SIGTERM', () => { /* cleanup */ })(沙箱禁了 process,所以正常情况做不到;但 vm.createContext 不阻止原型链上的 trap)。如果用 SIGTERM,沙箱超时检测可能失真——脚本自己清理 5 秒、又跑了 30 秒、再清理 5 秒,最后返回了一个过期的结果。 - 沙箱子进程本来就不应该持久化任何状态——子进程跑一批数据,写完 IPC 就退。SIGKILL 没机会 cleanup,对沙箱来说是无关紧要的代价。
- SIGKILL 一定生效——
kill -9在 Linux 上是SIGKILL,任何process.on('SIGKILL', ...)都不会被触发(不像 SIGTERM 有 graceful path)。用户脚本拦不住超时闸。
来看 SIGKILL 在 exit handler 里的识别:
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner-host.ts:274
if (signal === "SIGKILL") {
  reject(new Error(`沙箱被强制终止(超时); stderr=${stderrBuf.slice(0, 500)}`));
}
signal === 'SIGKILL' 这一行是"判定是不是超时闸触发的退出"的金标准——只有 setTimeout → child.kill('SIGKILL') 这一条路径能让 signal 等于 'SIGKILL'。child.kill()(不带信号名)默认发 SIGTERM,不会让 signal 等于 'SIGKILL'。
6.2 SIGTERM 在沙箱里的反模式
如果误把 SIGKILL 改成 SIGTERM,会发生什么?
- 子进程的
process.on('SIGTERM', ...)拦截(沙箱禁了 process,但有些 trap 通过原型链走通) - 用户脚本 cleanup 代码可能调用
console.log('saving...'),写大量数据到 stderr process.exit(0)优雅退出,exit code 是 0,但 IPC message 已经丢了- 父进程收到
signal === 'SIGTERM'、code 是 0,落入"沙箱未返回结果"分支——reject 报错
结论:用 SIGKILL 是用"放弃 cleanup"的代价,换"超时检测永远生效"的保证。沙箱场景下这个取舍是清楚的——业务脚本本来就不应该持久化状态。
6.3 SIGKILL 之后的资源回收
SIGKILL 是"硬杀",不释放句柄。沙箱子进程里最危险的句柄是 PrismaClient 连接池(query 助手用到)。这就是为什么 sandbox-runner.ts 里有一段强制 disconnect:
// apps/api/src/biz_reconciliation/parse-scripts/sandbox-runner.ts:454-457
const output = await processBatch(msg as SandboxBatchInput);
await disconnectSandboxPrisma();   // ← 强制断开 Prisma 连接池
sendAndExit(output, 0);
如果子进程被 SIGKILL,disconnectSandboxPrisma() 没机会跑——Prisma 连接会在父进程侧悬挂。Node.js 的事件循环会因为 Prisma 句柄没关而保持活跃,子进程退出后父进程可能看到"Phantom child process"。生产经验告诉我们:SIGKILL 之后 1-2 秒内,父进程的 PrismaClient 也会被 GC(因为 Node.js 检测到子进程 fd 失效),但这一两秒的窗口里 Sentry 上能看到一条"PrismaClient 句柄泄漏"的告警。这是 SIGKILL 的隐性代价,可接受但不优雅。
七、失控脚本的 4 种结局:完整回放
把上面所有信号拼起来,4 种结局在生产环境里的真实日志长这样(脱敏):
7.1 超时(单行死循环)
[2026-03-15 02:14:23] [sandbox-runner] child forked (pid=147283), batchSize=100
[2026-03-15 02:14:23] [sandbox-runner] child.send(input) 1024 rows
[2026-03-15 02:14:53] [sandbox-runner] setTimeout → SIGKILL (30000ms)
[2026-03-15 02:14:53] [sandbox-runner] child.on('exit', code=null, signal='SIGKILL')
[2026-03-15 02:14:53] [sandbox-runner] stderrBuf=''
[2026-03-15 02:14:53] JobTask[INC-202603-738] FAILED, errorMessage='沙箱被强制终止(超时); stderr='
定位关键:signal === 'SIGKILL' + stderr 为空 + durationMs ≈ 30000 → 业务脚本进入了异步死循环或长阻塞。
7.2 OOM
[2026-03-15 02:18:11] [sandbox-runner] child forked (pid=147301)
[2026-03-15 02:18:11] [sandbox-runner] child.send(input) 1024 rows
[2026-03-15 02:18:14] [sandbox-runner] child.stderr <data>: 'FATAL ERROR: invalid array length Allocation failed - process out of memory\n'
[2026-03-15 02:18:15] [sandbox-runner] child.on('exit', code=134, signal=null)
[2026-03-15 02:18:15] [sandbox-runner] stderrBuf='FATAL ERROR: invalid array length Allocation failed - process out of memory\n'
[2026-03-15 02:18:15] JobTask[INC-202603-742] FAILED, errorMessage='沙箱退出码 134; stderr=FATAL ERROR: invalid array length ...'
定位关键:code=134(SIGABRT) + stderr 含 FATAL ERROR: ... Allocation failed + durationMs 只有几秒 → V8 OOM,立刻告警。
7.3 异常逃逸(脚本 throw 未 try/catch)
[2026-03-15 02:21:07] [sandbox-runner] child forked (pid=147321)
[2026-03-15 02:21:07] [sandbox-runner] child.send(input) 1024 rows
[2026-03-15 02:21:07] [sandbox-runner] child.stderr <data>: '<sandbox> TypeError: Cannot read property \'id\' of null\n'
[2026-03-15 02:21:07] [sandbox-runner] child.on('message', { results: [...], errors: [{ rowId: 'r-2025-003', error: 'TypeError: ...' }] })
[2026-03-15 02:21:07] [sandbox-runner] child.on('exit', code=0, signal=null)
[2026-03-15 02:21:07] JobTask[INC-202603-751] FAILED, errorMessage='沙箱返回格式错误: ...'
定位关键:IPC message 收到 { results, errors } + 业务异常 message 在 stderr → 业务脚本异常,定位到具体 rowId。
7.4 格式错误(脚本返回值非法)
[2026-03-15 02:23:42] [sandbox-runner] child forked (pid=147333)
[2026-03-15 02:23:42] [sandbox-runner] child.send(input) 1024 rows
[2026-03-15 02:23:42] [sandbox-runner] child.on('message', { results: [{ rowId: 'r-2025-001', status: 'FAILED', isAbnormal: true, abnormalReason: '脚本必须 export default 一个 reconcile 函数(编译结果:undefined)' }] })
[2026-03-15 02:23:42] JobTask[INC-202603-755] SUCCESS(rows 内个别 FAILED)
定位关键:整体 SUCCESS(沙箱没崩),但 abnormalReason 字段告诉业务人员"哪儿不对"——这是 4 种结局里唯一不触发沙箱整体失败的,因为它是业务错误不是技术错误。
八、监控告警接入:把可观测性变成可行动
日志和 durationMs 都到位之后,下一步是把它们接进监控告警系统。轻易云生产环境的告警规则是按这 5 条设的:
| 告警 ID | 触发条件 | 严重级别 | 处置路径 |
|---|---|---|---|
SBX-OOM-001 | stderr contains 'FATAL ERROR' OR 'Allocation failed' | P1 | 自动隔离问题脚本 + 通知 SRE |
SBX-TIMEOUT-002 | durationMs_batch > 28000ms 持续 5 分钟 | P2 | 通知业务人员优化脚本 |
SBX-STUCK-003 | IncomePlan: reconciling 堆积 > 30 个 | P1 | SRE 介入 |
SBX-DURATION-P99-004 | durationMs_row P99 > 5s | P3 | 通知业务人员 + 建议加慢查询 |
SBX-IPC-LOSS-005 | errorMessage contains '沙箱未返回结果' 频率 > 1/1000 | P2 | 通知 SRE 检查 IPC 通道 |
把这 5 条规则挂在 Grafana + Prometheus 上,对应到上面那张 arch-024 监控告警架构图里的"日志监控 + 链路追踪"两条数据源。
效果是:失控脚本从"上线后第 7 天 SRE 被叫醒"变成"上线后 30 秒 P1 告警"。开篇那个凌晨 2 点的电话——如果当时有这套告警,会在脚本跑第 5 个批次时就触发,业务人员还没下班就能收到通知。
九、给 SRE 的 4 条实践建议
把上面的设计压缩成 4 条可执行的实践建议:
-
3 层 durationMs 必须同时埋——行级、批次级、JobTask 级。三层一起看才能区分"单行失控"和"整批失控",缺一层就只能事后救火。
-
stderr 是失控的第一现场,500 字符够用——别小看 stderr;V8 panic、Node.js unhandledRejection、OOM 都在这里。JobTask.errorMessage 字段给它留 500 字符的预算,其他留给业务信息。
-
signal === 'SIGKILL'是判定超时的金标准——别试图用 SIGTERM 走"优雅退出"。沙箱场景下,超时检测准确性 > cleanup 优雅度。 -
告警规则必须能在 4 种结局里找到对应信号——任何监控规则都用
arch-024那张图的"3+1"结构反推一遍:4 种结局 × 3 条数据源 = 12 个潜在告警位,至少要覆盖 P1/P2 6 条。
十、收尾
回到开篇那个凌晨 2 点的电话。
事故复盘的最终结论不是"业务人员写错了脚本"——业务人员写错脚本永远会发生。真正的问题是:沙箱知道这次失败的所有细节(IPC 失败 / stderr 关键字 / SIGKILL 触发 / durationMs 异动),但没有任何一条日志按"事故响应"的消费方式组织起来,让 SRE 在 30 秒内拿到可行动的信息。
沙箱日志与监控的本质,是把沙箱自己产生的可观测性原料,变成SRE 能直接消费的告警和画像。这件事比"沙箱本身够不够安全"更重要——一个沙箱再安全,如果失控时你看不到发生了什么,就等于失控。
这套监控体系在生产环境跑了 1 年以上,从最初靠 SRE 肉眼盯 JobTask 列表,到现在的 5 条 P1/P2 告警自动触发 + 4 种失控结局的画像速查手册。这条路不是设计出来的,是被凌晨 2 点的电话一次次"逼"出来的——失控脚本无处遁形,靠的不是沙箱本身,而是把沙箱的所有信号都结构化记录下来。
如果你正在评估对账系统的脚本能力,问 SRE 一句话:"你们的沙箱,失控时 30 秒内能不能自动告警?"——答不上来的,都是"沙箱能跑但不能看"。
本篇配套的沙箱契约、试跑端点、双层沙箱基础,参见 .opencode/skills/parse-script-development/SKILL.md / reconciliation-script-development/SKILL.md / ai-agent-development/SKILL.md(项目内的专项 skill 文档)。监控告警架构图来自项目资产 arch-024 / arch-028。