
一次对账到底要准备多少工作量:15 个平台的账单体量与工时估算表
摘要:每到排下个月的班表,财务都要重新猜一次工作量。这篇把猜换成算:十五个平台的账单体量分四档,同一家公司里不同平台的单位工时能差 5 倍以上;三段工时公式怎么列,每段按什么口径计量;三档规模配几个人、怎么分工;还有一个反直觉的结论——最耗时间的不是对账本身,而是差异处置那一段。 关键词:对账工作量、账单体量、工时估算、对账排期、电商财务人力、月结排班
一、排下个月的班表,为什么每次都要重猜一遍
十二月的收尾那一周,财务经理要把一月的排班表贴出来。桌上摊着三样东西:各平台账期到达日历、去年的月结复盘表、人力表。
难的是那个数。有人按订单量估,上月三千单,这月三千单,一个人扛。有人说按销售额估,上月两百万,一个人加半个。运营负责人提醒"这个月大促,单量要翻倍",财务经理心里没底。
于是常见的结果是两种。一种是月初按乐观排,月中发现差异处理不完,月末三天全在加班;另一种是按悲观排了两个人,第二天到岗就没事干。
排班表上那个数,不是一个客观量,是三种口径打了一次架的结果。 没人算错,各自都按自己那一套估,估完合起来就偏了。
二、按单量估人,为什么一定估不准
问题的根子在"一行"到底指什么。
同一笔生意在不同平台的账单里被拆成的行数不一样。亚马逊加拿大站一份交易明细 4,856 条,其中一行订单会被拆成 6 条核算行。 换个平台可能就一行。这一拆,账单行数和订单数就不在同一个量纲上了。
再看列。独立站三个账单摆在一起:PayPal 账单 41 列 456 行,Stripe 账单 9 列 1,007 行,空中云汇 58 列 48 行。列最多的那个只有 48 行,列最少的有 1,007 行。 行数和列数交叉着长,谁大谁小看的是账单结构,不是交易规模。
解析之后还会再膨胀一次。京东 POP 营销对账账单解析后 17,952 行,符号违例 0 行。京东 POP 账户流水一份账单只有 220 行,收入 141,430.71 元、费用 63,889.25 元。 按行数看是营销那份更重,按差异看未必。
所以"这个月多少单"这个输入,本身就是不完整的。
工时真正跟着走的是三样东西:账单行数、账单列数、差异率。 前两样决定你要看多少行、多长的表,第三样决定你要解释多少个为什么。顺序不是量越大越久,而是差异越多越久。传统估法只测了第一样。
三、十五个平台的账单体量,不是一个量级
先把盘子摆出来。当前启用的店铺 35 家,账单总数 45 份,一个完整账期的供应链订单 45.38 万条。 已登记的账单类型 25 类,分布在 10 个平台,平台侧还有 9 个平台在排队接入。
也就是说,团队手上有 35 张嘴要喂,每张嘴吃的东西还不一样。
按单账期的账单行量,平台大致分四档:
| 档位 | 典型形态 | 单账期账单行量 | 结构特征 | 月度工时量级(经验区间) |
|---|---|---|---|---|
| 轻量店 | 单平台单店,单一账单 | 数百行级 | 一笔订单一行,字段少 | 半天到一天 |
| 中型店 | 多账单类型,含费用侧 | 数千行级 | 要拼桥表,差异开始出现 | 两到四天 |
| 大型店 | 多平台多店,含营销与分摊 | 一万行级以上 | 解析后行数膨胀,差异成批 | 一周以上 |
| 头部店 | 头部平台加跨境多币种 | 数万行级 | 单次转换就可能出上万张单据 | 需要专职差异岗 |
这四档的分界不是拍的。速卖通一个账期 828 条体行,落在轻量到中型之间。亚马逊加拿大站一份交易明细 4,856 条,但一行订单拆成 6 条核算行,实际处理量远大于 4,856 这个数。
亚马逊美国站一个账期 14,682 单,收入 480,293.96 元、费用 151,921.31 元、差异 −352.90 元,对账过程 1 分 17 秒跑完。 这是最反直觉的一条:单量上万,机器一分多钟就跑完了,人力的大头根本不在"跑"上。如果走这条路,譬如平台口径先固化,轻易云的十五个平台规则已内置,分档才敢按平台口径分,而不是按运营各自导的表分。
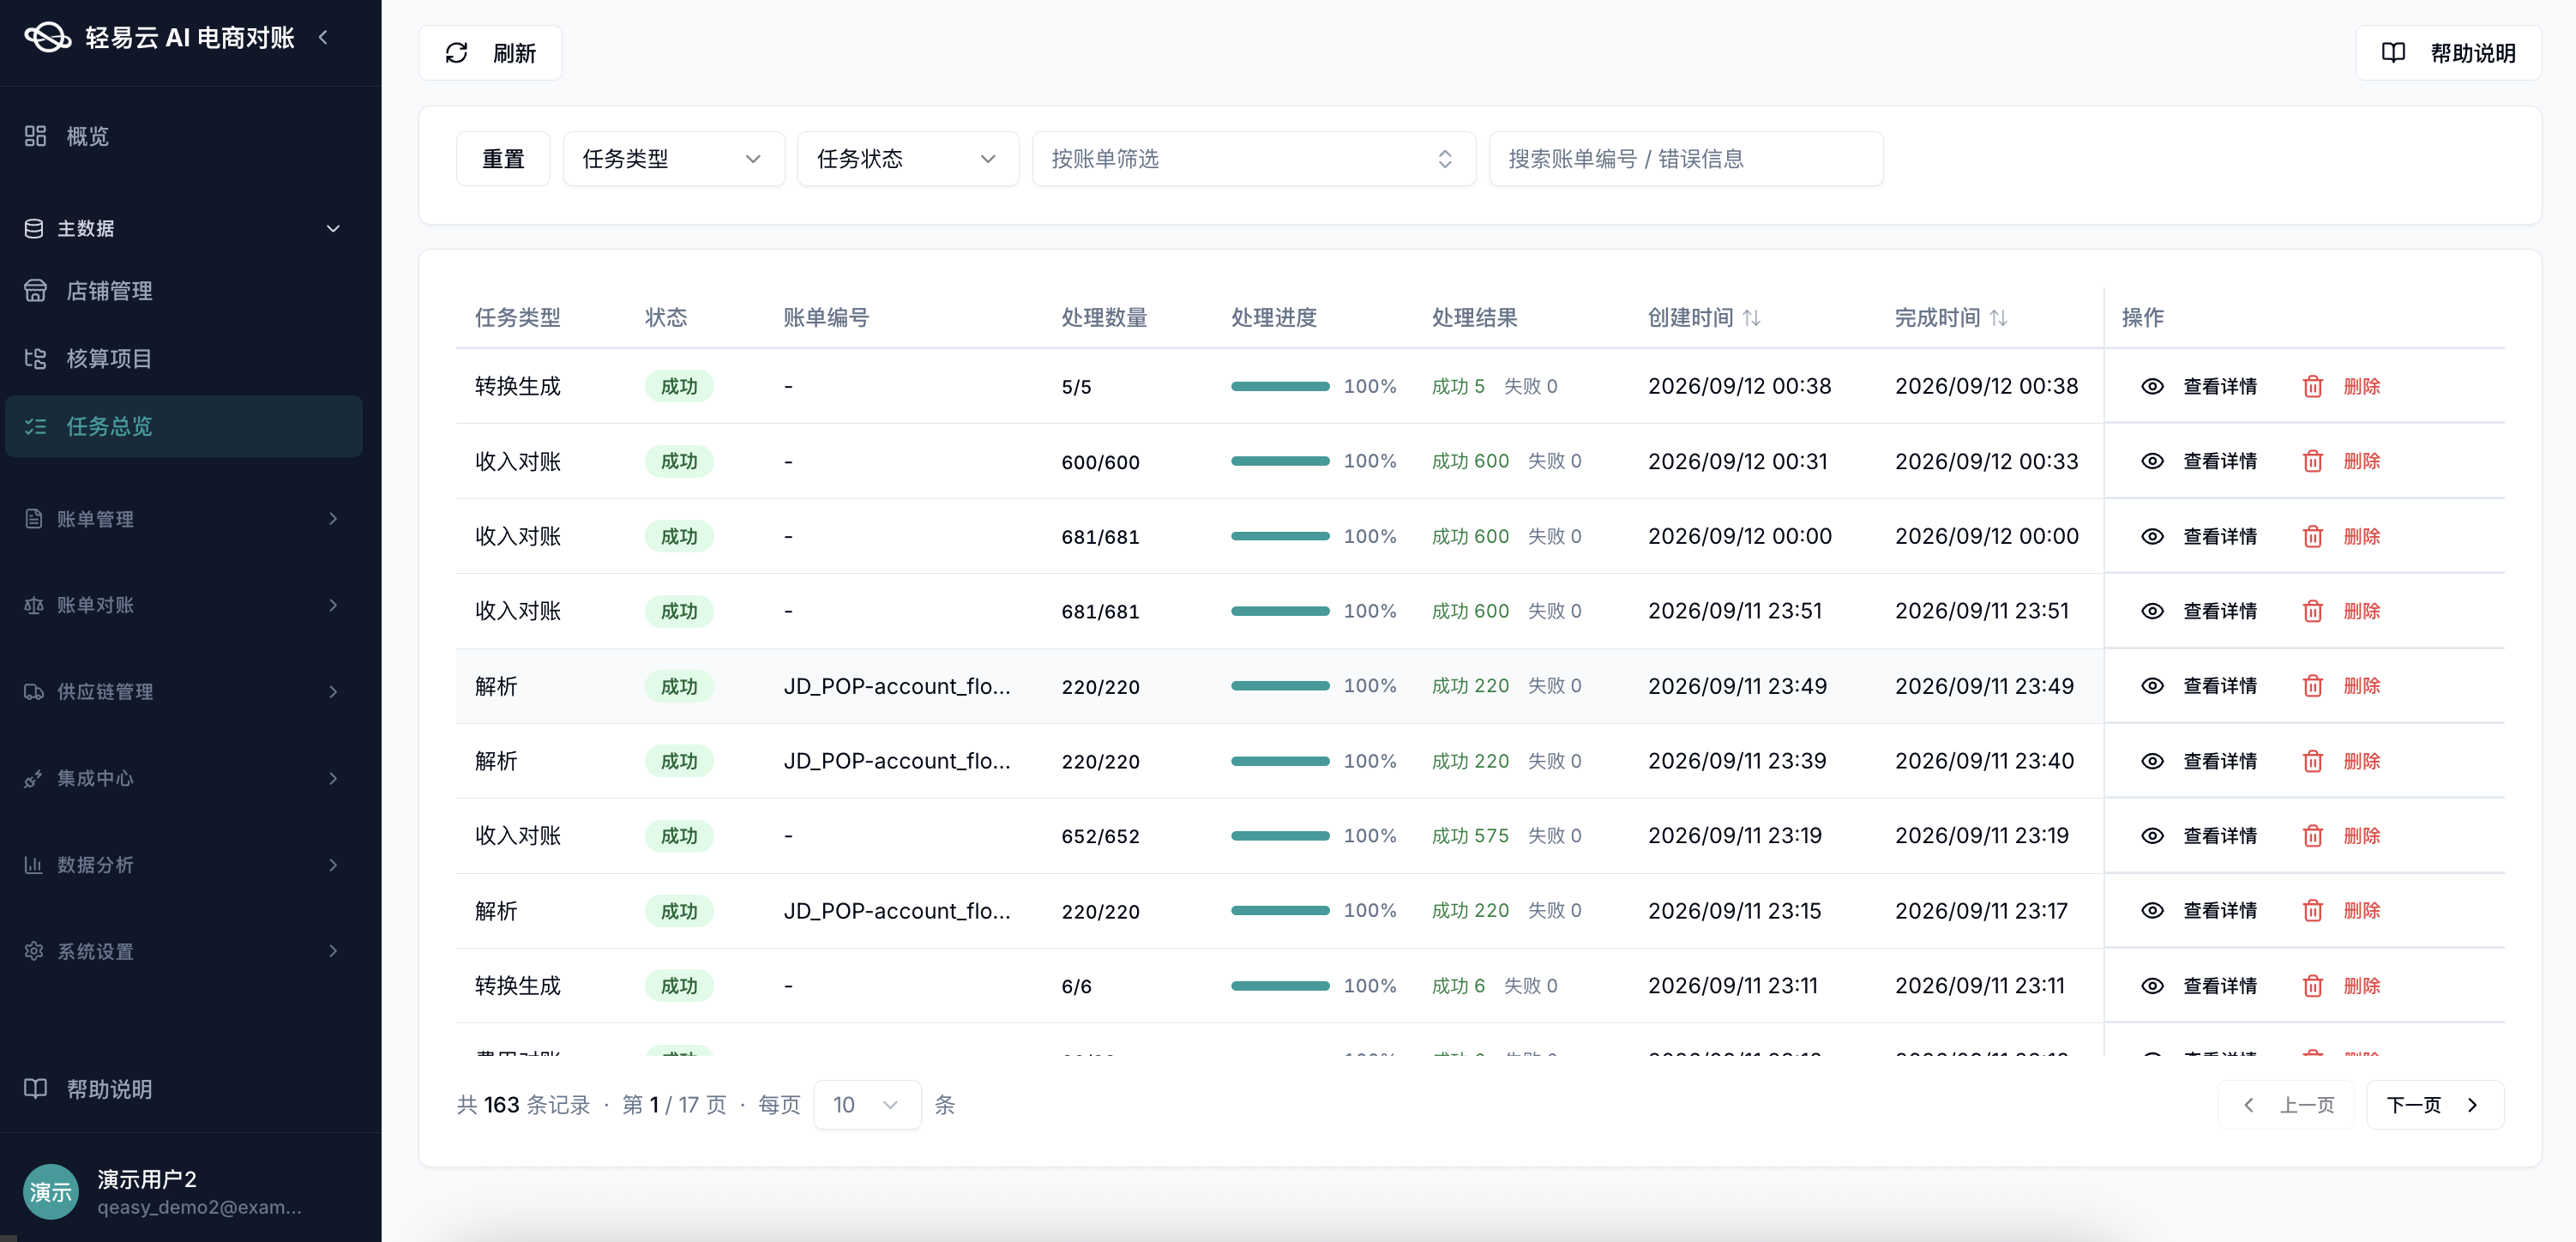
这张界面上有 163 条任务,每条都带处理数量和处理进度。把"这个月有多少活"翻译成"有多少条任务、总共要处理多少行",排班就从感觉变成了数。 那些标着失败的条目,恰恰是差异处置工作量的来源。
四、工时不是一笔账,是三段账
把一次月结对账拆开,真正花时间的有三段,性质完全不同。
第一段,导入与校验。把各平台的原始账单搬进来,检查列名、编码、金额符号有没有异常。账单导入有体量闸,单文件 50MB 上限;实测一份 76MB 的文件裁掉 17 列之后剩 201,774 行,另一份 23MB 的文件有 54,280 行,内存从 513MB 降到 334MB。 这段的耗时几乎全花在处理之前:确认文件对不对、列要不要裁、格式有没有变。
第二段,解析与核对。把账单行拆成核算行,与业务订单、平台流水对上。速卖通一个账期 828 条体行,亚马逊美国站一个账期 14,682 单,量都不小,但这一段大部分是机器时间。任务总览 163 条任务全部成功、进度 100%,多数在 1 到 2 分钟内完成。
第三段,差异处置。找到对不上的行,判断原因,发起查询或者出单。14,856 单对账里 14,851 成功、5 失败,这 5 条失败行落在人身上,机器重试不掉。失败按指数退避重试 3 次,1 秒到 2 秒到 4 秒,三次之后还不行,就转人工。
三段的经验区间大致是这样:
| 段 | 计量口径 | 经验区间 | 谁做 | 会不会超 |
|---|---|---|---|---|
| 导入与校验 | 每万行账单行 | 0.5 到 1 小时 | 核算专员 | 很少 |
| 解析与核对 | 每万行账单行 | 1 到 2 小时 | 核算专员 | 偶尔 |
| 差异处置 | 每千条差异行 | 1 到 3 小时 | 差异处置岗 | 经常,且难预估 |
这三段单价是经验区间,不是任何一套系统的官方指标。换一个平台结构就要重新测一轮。 用之前先拿一个完整账期实测,把自己的三段单价填进这张表。
填好单价之后,月度工时就是一行乘法:账单行数除以一万乘第一段单价,核算行数除以一万乘第二段,差异行数除以一千乘第三段,三项相加。

这张流程图值得看的是最右边那三个圈:10 行 2 秒、500 行 10 秒、1200 行 30 秒。导入的机器耗时随行数线性增长,但基数很小。 排班时把力气花在校验文件格式上,比花在催导入快得多。
五、三档规模配几个人,以及谁才是大头
先回答人力配置。规模分三档,配法不一样。差异判定单独拆一档,我们在轻易云上这么落:解析沙箱跑一遍、集成转换出单、报表分析出差异分布,人只碰判断这一段。
| 规模档 | 对应平台量级 | 建议人力 | 分工方式 | 排班要点 |
|---|---|---|---|---|
| 一人多店 | 十个平台以内,单平台多店 | 一人加兼职支援 | 一人主对账,差异批量找运营 | 别把这个人的五天排满,留一天缓冲 |
| 一店一人 | 十个到十五个平台,店数多 | 两到三人按平台分组 | 每人认四到五个平台,只做导入与核对 | 差异统一交给下一档 |
| 专职差异处置 | 头部店,单店量级大 | 差异岗一人独立 | 只做差异判定与出单,不碰导入 | 这个人按差异率排,不按单量排 |
三档之外还有一条硬约束:专职差异处置这一档不能省。 只要差异率不是零,差异就会从对账岗溢出来,溢到哪里取决于谁扛。
而这一段恰恰是最不该按单量估的。导入和解析是分钟级的,差异处置是小时级的。 亚马逊美国站一个账期 14,682 单、差异 −352.90 元,机器 1 分 17 秒跑完;亚马逊加拿大站一行订单被拆成 6 条核算行,差异行数就是订单的几倍。差异处置的耗时随差异率线性放大,却跟账本体量不成正比。 这就是按单量估人一定错的机制。
还有一条反直觉的横向差异:同一家公司里,不同平台的单位工时能差 5 倍以上。 原因还是账单结构,有的平台一笔订单一行,有的平台一笔订单六行。拿"工时除以单量"这个指标横向比平台,结论会正好反着来:结构松散的平台显得效率高,结构复杂的平台显得效率低,其实后者的人力大头在拆行和合行上,那部分在两种口径里都看不见。

这张图里收入对账 95%、费用对账 90%、公摊分摊 88%、集成转换 75%、报表分析 85%,还有账单导入 85%、解析沙箱 80%。差异处置不是一个动作,是这几个模块串起来的一串动作。 它的工时也该按这个串来估,而不是按处理了多少单来估。分工同理:不要按平台切人,要按能力域切人,一个核算专员可以同时负责几个平台的导入,差异判定交给专岗。
六、用任务进度替代"这个月忙不忙"的感觉
排班表上那个数,理想状态是每月从系统里读出来,而不是每个月重新猜。
任务进度有四件套:总数、已处理、成功、失败。 这四个数加上失败率、再加上重试次数,就够判断这个月要不要加人。开篇那个"重猜一个月工作量"的问题,在轻易云这类把任务进度摊开给排班表看的系统里,会变成一次拿数据说话的决定。
| 指标 | 怎么看 | 触发什么动作 |
|---|---|---|
| 总数 | 这个账期一共派了多少条任务 | 比上月多,说明账单结构或店数有变动 |
| 已处理 | 跑到哪儿了 | 用来定哪天能开始差异处置 |
| 成功 | 机器消化了多少 | 剩下的差额就是人的工作量 |
| 失败 | 有多少行没自动过 | 失败率抬了,就要预留差异岗时间 |
| 重试次数 | 失败按指数退避重试 3 次 | 重试到 3 次还失败的,别等系统,直接转人工 |
这张表的意思是:忙不忙不是感觉,是失败率乘以差异行数。 亚马逊美国站那种量级——14,682 单、差异 −352.90 元、1 分 17 秒跑完——失败率极低,人几乎不用管;另一个平台一行订单拆成 6 条核算行、差异行数翻几倍,失败率稍高,人工量就上来了。
还有一个必须盯的量:5 万体行会出 52,601 张单据,单次转换 86 秒,超过 600 秒上限整体回滚。 出单量是体行的量级放大,机器在边界内跑,人得跟着这条边界排人。

这张测算图把账算得很直白:人力成本、错误成本、风险成本三项拆开算。把人从按单量估的坑里拉出来,本身就是人力成本那一栏的算法修正。 错误成本那栏是错误率乘对账额再乘修正成本,风险成本那栏是审计不合规罚款的区间。回到排班这件事:先确定哪一段工时能省,再定省下来的人往哪一档挪,比直接拍脑袋加一个人可靠。
七、收尾:三条能当天执行的动作
第一条,把上个月每个平台的账单行数、核算行数、差异行数三列拉出来。 三个数分别对应三段工时。缺差异行数这一列,就永远只能按单量估。
第二条,给每个平台各填一张三段单价表。 导入、解析、差异三段各一个经验单价,用最近一个完整账期实测出来。填完这张表,估算才从拍脑袋变成乘法。
第三条,给这个月的排班表加一列:差异处置预留。 这一列按差异率乘差异行数填,不按订单量填。它是唯一能回答要不要加人、加在哪一档的那一列。
三张表填完,这个月的班表就是算出来的,不是猜出来的。排班表上那个数,也就有了一个下个月能被复核的出处。